Herramienta vs. Proceso: Por qué la Adopción de IA en México No se Traduce en Resultados
Lo que se reporta como adopción de IA mide uso superficial de herramientas, no rediseño de procesos. Esa distinción importa: la herramienta sola produce ganancias de tarea reales pero irregulares, y convertirlas en resultados de la organización parece requerir inversiones organizacionales complementarias, algo que la evidencia todavía no observa a dos o tres años.
Un análisis con datos primarios de Anthropic, OpenAI y Google, cruzados con evidencia institucional mexicana.
Revisión del 12 de octubre de 2026. Una revisión escéptica externa replicó las cifras de análisis propio al decimal y encontró cinco problemas de interpretación y atribución. Este documento los corrige y deja constancia en la bitácora de revisiones. La tesis central sigue en pie, apoyada en McKinsey, Google ATLAS, PwC y el rezago de México ajustado por ingreso. El capítulo estatal (volumen y amplitud por estado) queda abierto: su respuesta se retiró.
Resumen ejecutivo
Este documento examina una tesis central: la mayoría de lo que se reporta como "adopción de inteligencia artificial" en México y en el mundo mide uso superficial de herramientas (aceleración de artefactos como documentos, hojas de cálculo o presentaciones) y no rediseño real de procesos de negocio. Esa distinción importa: la herramienta sola produce ganancias de tarea reales pero irregulares (experimentos con +15%, −40% de tiempo y +26% sin rediseño: Brynjolfsson, Li y Raymond 2025, https://doi.org/10.1093/qje/qjae044; Noy y Zhang 2023, https://doi.org/10.1126/science.adh2586; Cui et al. 2026, https://doi.org/10.1287/mnsc.2025.00535), y convertirlas en resultados de la organización parece requerir inversiones organizacionales complementarias (Bloom, Sadun y Van Reenen 2012, https://doi.org/10.1257/aer.102.1.167; Humlum y Vestergaard 2026, https://doi.org/10.3386/w33777), algo que la evidencia todavía no observa a dos o tres años. La versión anterior de este documento sostenía que la distinción, y no la disponibilidad de la tecnología, separa a quien captura valor de quien no; esa versión fuerte está contradicha por experimentos con ganancias sin rediseño y se retiró el 12 de octubre de 2026.
Para probar esta tesis cruzamos tres tipos de evidencia:
- 01Datos primarios de uso real de IA de los tres observatorios económicos más rigurosos que existen hoy: el Anthropic Economic Index [1] (con análisis propio sobre el dataset completo de más de 1.6 millones de registros, con corte específico para México y sus 25 estados con datos disponibles), el estudio "How People Use ChatGPT" de OpenAI/NBER [4], y el recién publicado Google AI & Economy ATLAS v1.0 [5].
- 02Estudios institucionales de adopción empresarial (McKinsey [6], BCG [7], MIT NANDA [8] y PwC [9]), que documentan de forma consistente una brecha entre uso y captura de valor.
- 03Evidencia mexicana específica: Censos Económicos 2024 del INEGI [10], un estudio sectorial de manufactura [11], y el Informe de Madurez Digital de AmCham y Needed Education [12].
Los hallazgos centrales son:
- México ocupa el puesto 76 de 121 países en el Índice de Uso per cápita de Claude, con un índice de 0.63x (1.0x es el uso proporcional a su población de 15 a 64 años) [1]. Está por debajo de Uruguay, Chile, Argentina, Colombia, Perú y Brasil. El índice no ajusta por ingreso, así que se ajustó: el PIB por persona en edad de trabajar explica 84.5% de la variación internacional y, con ese control, México queda en el lugar 109 de 120, peor que sin ajustar.
- El INEGI registra sistemas de IA en 2.1% de las unidades económicas que usan herramientas digitales (26,093 unidades, que son 0.5% del total de 5.45 millones; año de referencia 2023) [10]. Las encuestas de proveedores reportan 60-70%, pero no muestrean a las cuatro millones de unidades sin internet, y un módulo de Banxico de junio de 2026 reporta 48.5% en establecimientos de más de 100 trabajadores [16]. La distancia mezcla definición, población muestreada y fecha, y estos datos no permiten repartirla.
- A nivel global, solo entre 5% y 6% de las organizaciones captura retornos financieros reales de la IA [6], [7], y el factor que mejor predice ese resultado no es qué modelo usan, sino si rediseñaron su flujo de trabajo, algo que solo 21% de los adoptantes ha hecho [6].
- Dentro de México, el uso real de Claude está fuertemente concentrado en tareas cognitivas de aceleración (código, contenido, tareas escolares), con una presencia mucho más marginal en varias categorías ocupacionales de mayor complejidad de proceso [1]. Ese corte describe a la base de usuarios de Claude, y en las medidas de profundidad que el dataset trae (artefactos de oficina, automatización) México no se distingue de sus vecinos de la región.
- Los cinco estados más adoptantes (Ciudad de México, Nuevo León, Jalisco, Estado de México y Puebla) concentran más del 60% de todo el uso nacional, y su perfil de uso es notablemente uniforme: todos dominados por la misma categoría técnica, sin evidencia de que la concentración geográfica se traduzca en mayor profundidad de proceso [1].
- Al comparar a los cinco estados líderes contra los cinco con menor adopción (Chiapas, Tabasco, Morelos, Oaxaca, Aguascalientes), la diferencia no está en para qué se usa la IA (la mezcla de trabajo, uso personal y escolar es casi idéntica entre ambos grupos), sino en el volumen (13.6 veces mayor en el grupo líder) y en la amplitud de ocupaciones donde la herramienta ya es detectable (casi el doble en el grupo líder) [1]. Esa amplitud depende del umbral de privacidad del dataset, como muestra el punto siguiente.
- La correlación entre volumen y amplitud en los 25 estados (r = 0.957) se retiró como hallazgo el 12 de octubre de 2026: un modelo en el que ningún estado tiene más amplitud real que otro produce r = 0.961 (IC 95% 0.942 a 0.976) [1]. El indicador mide el umbral de privacidad y no tiene poder para detectar diferencias de amplitud entre estados.
La conclusión no es que México esté "atrasado en tecnología": es que el patrón dominante, dentro y fuera de México, es usar IA para hacer más rápido lo que ya se hacía, no para repensar cómo se hace. Esa distinción es exactamente donde se abre una oportunidad de mercado real para ofertas de diagnóstico-primero.
1. Introducción y motivación
Entre 2025 y 2026, la narrativa pública sobre inteligencia artificial se ha instalado casi como un hecho consumado: "todas las empresas ya están usando IA", "quien no se sube se queda atrás", "el ahorro de tiempo es de 80%". Esta clase de afirmaciones circula con la misma seguridad tanto en artículos periodísticos como en propuestas comerciales de consultoras de todos los tamaños, y eso incluye, hay que decirlo con honestidad, a la propia industria de servicios de IA a la que pertenece quien escribe este documento.
El problema es que gran parte de esa narrativa se sostiene sobre cifras de adopción que miden cosas muy distintas entre sí, y que rara vez se ponen una al lado de la otra para ver si son compatibles. Que el 60% de una muestra de PyMEs diga que "ya usa IA" no es lo mismo que decir que el 60% de esas PyMEs tiene un proceso de negocio rediseñado alrededor de IA, y sin embargo ambas afirmaciones suelen presentarse con el mismo peso retórico.
Este documento nace de una pregunta práctica que se volvió una investigación más amplia: ¿qué tanto de lo que se reporta como "uso de IA" en México es en realidad aceleración de tareas de bajo valor de proceso (redactar un documento, armar una hoja de cálculo, generar una presentación) y qué tanto es una transformación real de cómo opera un negocio?
Para responderla de forma rigurosa, no especulativa, cruzamos tres fuentes de datos primarios sobre uso real de IA, de los tres laboratorios que hoy publican la evidencia más granular disponible públicamente [1], [4], [5], con estudios institucionales sobre adopción empresarial [6]–[9] y con estadística oficial mexicana [10]–[12].
1.1 Preguntas de investigación
La pregunta general anterior se descompone en cuatro preguntas concretas, cada una respondible con la evidencia disponible y cada una con una respuesta explícita en la Sección 4.9 y en las Conclusiones. Declararlas aquí, antes de presentar cualquier dato, tiene un propósito metodológico: impide que el documento se escriba hacia atrás desde su conclusión, eligiendo qué hallazgos contar según si la sostienen.
P1. ¿La adopción de IA que se reporta en México refleja adopción real de proceso, o mide uso superficial de herramienta? Es la pregunta que da nombre al documento. Se responde contrastando la adopción declarada en encuestas de proveedores contra la medición censal del INEGI [10] y contra el uso observado en datos primarios [1].
P2. ¿El rezago mexicano en uso de IA es frente al mundo, o frente a su propia región? El discurso público mexicano encuadra la comparación como "México frente al mundo". La pregunta es si ese es el marco correcto, o si oculta una brecha más cercana y más accionable.
P3. ¿La desigualdad de adopción entre estados mexicanos se explica por volumen de uso, por tipo de uso, o por amplitud de proceso? Las tres son hipótesis distintas con implicaciones de política pública opuestas: si es tipo de uso, el problema es cultural o educativo; si es volumen, es de acceso; si es amplitud, es de proceso. La respuesta publicada en versiones anteriores se retiró el 12 de octubre de 2026; ver Sección 4.9.
P4. ¿Qué distingue a las organizaciones que sí capturan valor financiero de la IA de las que no? Se responde con los cuatro estudios institucionales de gran escala [6]–[9], y es la pregunta que conecta el caso mexicano con el patrón global.
1.2 Declaración de conflicto de interés
Quien escribe este documento es fundador y director de Nuvnext, una plataforma de operación con IA para empresas mexicanas, que arma primero el mapa de los procesos de la empresa y después pone agentes a operarlos. La conclusión de la Sección 4.8 (que existe un espacio de mercado para una oferta que anteponga el diagnóstico del proceso al despliegue de tecnología) es, literalmente, una descripción del modelo de negocio del autor. Ese es un conflicto de interés directo y hay que nombrarlo antes de que el lector llegue a la conclusión, no después.
Tres consecuencias prácticas, declaradas para que el lector pueda descontarlas por su cuenta:
- Hay un incentivo a que la tesis sea cierta. Un documento que concluyera "las herramientas genéricas de IA bastan, no hace falta diagnóstico" sería comercialmente adverso para el autor. El lector debe asumir que ese incentivo existió durante la escritura, y evaluar la evidencia sabiéndolo.
- La mitigación es de método, no de intención. Declararse imparcial no sirve de nada. Lo que sí acota el sesgo es que toda la evidencia central sea de terceros verificables (INEGI, McKinsey, BCG, PwC, Google, el propio dataset público de Anthropic), que el documento declare su evidencia en contra (Sección 5) y su criterio de falsación (Sección 8), y que el dato original sea reproducible por cualquiera desde una fuente pública siguiendo el Anexo A.
- Dos de los mercados analizados son los del autor. Jalisco y Nuevo León, que aparecen en el segundo y tercer lugar de adopción nacional (Sección 3.2.4), son los estados donde opera Nuvnext. Ese dato se reporta como salió del análisis y no se le da peso argumental en ninguna conclusión.
Este documento no vende nada, no enlaza a ningún servicio y no contiene una llamada a la acción comercial. Eso no anula el conflicto; solo evita agravarlo.
2. Método y transparencia de fuentes
Antes de presentar cualquier hallazgo, es necesario ser explícito sobre qué mide cada fuente, quién la produjo, y qué no puede decirnos. Esta sección existe porque gran parte del problema que este documento denuncia (tomar cifras de adopción sin verificar su definición exacta) es un error fácil de cometer si no se es cuidadoso desde el principio.
2.1 Los tres observatorios económicos de IA
Existen hoy tres iniciativas de investigación económica primaria sobre uso real de IA, cada una con metodología pública y transparente:
Anthropic Economic Index [1], [2]. Analiza conversaciones anonimizadas de Claude.ai y de la API de primera parte, clasificando cada conversación contra las taxonomías oficiales O*NET (tareas) y SOC (ocupaciones) del Bureau of Labor Statistics de EE. UU. [2]. Es la única de las tres con una herramienta interactiva pública que permite consultar el desglose por país y, en el caso de Estados Unidos, por estado; y en su versión de datos descargables, por subregión de docenas de países, incluido México [1]. El análisis de México y de sus 25 estados con datos disponibles que se presenta en la Sección 3.2 de este documento es análisis propio, construido directamente sobre el archivo de datos completo (1,636,573 filas de datos para Claude.ai y 491,706 filas para la API de primera parte, con corte al 26 de junio de 2026), no una cita de un reporte ya publicado por Anthropic.
OpenAI / NBER: "How People Use ChatGPT" [4]. Un estudio académico coescrito por investigadores de OpenAI y el economista David Deming de Harvard, publicado como documento de trabajo del National Bureau of Economic Research. Analiza 1.5 millones de conversaciones de las cuentas de consumo de ChatGPT (Free, Plus, Pro) entre mayo de 2024 y julio de 2025. Es riguroso y con revisión metodológica sólida, pero no ofrece el desglose por país que sí tiene el Anthropic Economic Index: sus hallazgos son globales, con cortes demográficos (edad, género, nivel educativo).
Google: AI & Economy ATLAS v1.0 [5]. Publicado el 23 de julio de 2026 por un equipo conjunto de Google y Google DeepMind, con la participación de economistas externos como Diane Coyle (Universidad de Cambridge) y David Autor (MIT). Es, de las tres, la iniciativa metodológicamente más ambiciosa: analiza 15 millones de interacciones a través de Gemini App, Google AI Mode y la API de Gemini, mapeadas contra 800 ocupaciones, 4,000 tareas O*NET y, de forma novedosa, contra la Encuesta Americana de Uso del Tiempo (ATUS) para capturar usos fuera del trabajo. Su enfoque geográfico es distinto al de Anthropic: en vez de rankings país por país, analiza la relación entre PIB per cápita y adopción, y compara países OCDE contra no-OCDE. No publica un desglose específico para México como país individual dentro de este primer reporte.
La Tabla 1 resume el alcance comparativo de estas tres fuentes.
Tabla 1. Comparación de alcance metodológico entre los tres observatorios de IA
| Anthropic Economic Index [1], [2] | OpenAI/NBER [4] | Google ATLAS v1.0 [5] | |
|---|---|---|---|
| Muestra | Millones de conversaciones, actualización continua | 1.5 millones de conversaciones (may 2024–jul 2025) | 15 millones de interacciones (abril 2026) |
| Desglose por país | Sí, interactivo, incluye México | No | Parcial (OCDE vs. no-OCDE, correlación con PIB) |
| Desglose por estado de México | Sí (25 de 32 estados, con umbral de privacidad) | No | No |
| Cubre uso fuera del trabajo | Parcial | Sí | Sí, con marco ATUS completo |
| Cubre API/empresas | Sí | No (solo cuentas de consumo) | Parcial (sin API empresarial vía Google Cloud) |
| Revisión externa | Interna (Anthropic) | NBER, coautoría académica (Harvard) | Coautoría académica externa (Cambridge, MIT) |
2.2 Fuentes institucionales sobre adopción empresarial
Complementamos lo anterior con estudios de gran escala sobre adopción de IA en las organizaciones: McKinsey [6] (sobre encuesta a 1,993 organizaciones en 105 países), Boston Consulting Group [7] (sobre 1,250 empresas), MIT NANDA [8] (basado en 150 entrevistas a líderes, 350 encuestas a empleados y 300 despliegues públicos), y PwC [9] (4,454 CEOs en 95 países).
2.3 Fuentes mexicanas específicas
Para el contexto nacional usamos como fuente dura los Censos Económicos 2024 del INEGI [10], complementados con el estudio sectorial "México Inteligente: La manufactura frente a la oportunidad que no espera" del Centro México Digital [11] y con el Informe de Madurez Digital de AmCham/Needed Education [12]. Como contraste de fecha más reciente se usa el módulo de IA de la EMAER del Banco de México (junio de 2026), citado a partir de prensa [16].
2.4 Sobre la traducción de las categorías ocupacionales
Las categorías ocupacionales que usa el Anthropic Economic Index son las del sistema SOC del Bureau of Labor Statistics de Estados Unidos, publicadas en inglés. En este documento se presentan traducidas al español porque un lector hispanohablante no debería tener que traducir mentalmente una tabla para leerla. La equivalencia exacta entre cada nombre en español y su denominación original en SOC está en el Anexo A, para que cualquier persona pueda reproducir el análisis contra el dataset original sin ambigüedad. Los nombres de temas de conversación que el dataset reporta como cadenas literales ("Homework", "Business operations") se conservan en inglés con su traducción entre paréntesis, porque son valores del dato, no etiquetas de una taxonomía.
2.5 Límites que hay que declarar de entrada
Ningún dato en este documento mide "adopción de IA" en abstracto: cada uno mide el uso de un producto específico (Claude, ChatGPT consumo, Gemini) o una encuesta con su propia definición de "usar IA". Cuando las cifras de distintas fuentes parecen contradecirse (por ejemplo, 2.1% de las unidades con herramientas digitales según el INEGI contra 60%+ según encuestas de proveedores), la explicación está en la definición, en la población muestreada y en la fecha, no en un error de medición, y en este documento se hace explícito en cada caso qué se está midiendo realmente.
2.6 Cómo leer las Secciones 3 y 4
La Sección 3 presenta resultados y solo resultados: qué dicen los datos, sin lectura del autor. La Sección 4 discute qué significan, y ahí sí la voz es interpretativa. La separación es deliberada y tiene un costo de lectura (obliga a ir y volver entre secciones) que se acepta a cambio de algo que importa más en un documento con el conflicto de interés declarado en la Sección 1.2: que el lector pueda quedarse con la Sección 3 y descartar entera la Sección 4 si no le convence quién la escribe. Los datos no dependen de la interpretación; la interpretación sí depende de los datos, y así queda visible cuál es cuál.
3. Resultados
3.1 Panorama global: la brecha entre uso e impacto
McKinsey, en su encuesta a 1,993 organizaciones en 105 países [6], encuentra que 88% de las organizaciones ya usa IA regularmente en al menos una función de negocio. Sin embargo, solo 39% reporta cualquier impacto medible en su utilidad de operación (EBIT), y de ese grupo, la mayoría reporta un impacto menor al 5%. Los llamados "AI high performers" (organizaciones con impacto en EBIT de al menos 5% y que reportan valor "significativo") representan apenas 5.5%, cerca del 6%, de la muestra total.
Boston Consulting Group [7] llega a una conclusión casi idéntica desde una metodología distinta: de 1,250 empresas analizadas, solo 5% califica como "future-built" (empresas que capturan retornos sustanciales de IA), mientras que 60% son "laggards" que reportan ganancias mínimas en ingresos y costos. Las empresas "future-built" logran, en promedio, 1.7 veces el crecimiento de ingresos, 3.6 veces el retorno total al accionista y 1.6 veces el margen de EBIT de las rezagadas.
MIT NANDA [8] documenta que apenas 5% de los pilotos de IA generativa integrados logra extraer valor medible, mientras la gran mayoría permanece sin impacto observable en el estado de resultados. Este reporte no ha pasado por revisión por pares y su muestra es relativamente pequeña; se registra aquí como hallazgo preliminar consistente con las otras fuentes, no como un hecho establecido de forma aislada.
PwC [9] encuentra que 56% de los CEOs dice no haber obtenido nada de sus inversiones en IA, y solo 12% reporta que la IA está simultáneamente aumentando ingresos y reduciendo costos.
Tomando en cada una su umbral más estricto, estas fuentes [6], [7], [9] quedan entre 5% y 12%. Con umbrales menos estrictos el rango se abre: en PwC, 30% de los CEO reporta más ingresos y 26% menores costos, de modo que cerca de 44% reporta al menos uno de los dos beneficios [9] (cálculo propio con las proporciones publicadas: 30% + 26% − 12%). Las cuatro son encuestas transversales y autorreportadas, y la cifra de MIT NANDA [8] no tiene derivación ni microdatos públicos, por lo que no se usa para el rango. La convergencia es en buena parte efecto de elegir el umbral.
Sobre qué distingue a ese grupo, McKinsey [6] reporta un resultado directo: de 25 atributos organizacionales analizados, el rediseño fundamental de flujos de trabajo es el que presenta la correlación individual más fuerte con impacto en EBIT, por encima de cualquier otra variable medida, incluidos qué modelo de IA se usa y cuánto se invierte. En la misma muestra, solo 21% de las organizaciones que adoptaron IA ha rediseñado efectivamente algún flujo de trabajo.
BCG [7] reporta un reparto de esfuerzo consistente con lo anterior, su marco "10-20-70": del esfuerzo necesario para capturar valor de IA, 10% corresponde a los algoritmos, 20% a la tecnología que los rodea y 70% a las personas y los procesos. Las empresas que concentran la inversión en la tecnología misma, sin modificar el proceso, son las que menos retorno reportan.
3.2 México en el Anthropic Economic Index
Esta sección presenta análisis original, construido directamente sobre el dataset completo descargable del Anthropic Economic Index [1] (corte al 26 de junio de 2026), no sobre cifras ya publicadas por Anthropic en sus reportes narrativos.
3.2.1 Panorama nacional
México ocupa la posición 76 de 121 países evaluados en el Índice de Uso per cápita de Claude, con un valor de 0.63x; es decir, el uso observado es 37% menor al que correspondería a su participación en la población de 15 a 64 años [1]. El índice es participación de uso entre participación de población en edad de trabajar y no ajusta por PIB. El 1.0x es el agregado global, no un promedio de países: entre los 120 países con datos de ingreso, la mediana es 0.97 y el promedio simple 1.50.
Tabla 2. Índice de uso de Claude por país, América Latina (mayo 2026)
| País | Índice de uso | Ranking global (de 121) |
|---|---|---|
| Uruguay | 1.89 | 33 |
| Chile | 1.84 | 35 |
| Puerto Rico | 1.68 | 40 |
| Costa Rica | 1.57 | 42 |
| Argentina | 1.48 | 45 |
| Panamá | 1.28 | 54 |
| Colombia | 1.18 | 55 |
| Perú | 1.05 | 57 |
| Brasil | 0.96 | 62 |
| República Dominicana | 0.67 | 72 |
| México | 0.63 | 76 |
| Paraguay | 0.59 | 78 |
| El Salvador | 0.59 | 79 |
| Ecuador | 0.58 | 80 |
| Bolivia | 0.56 | 81 |
| Guatemala | 0.37 | 97 |
| Honduras | 0.26 | 105 |
Fuente: análisis propio sobre Anthropic Economic Index dataset [1], métrica usage_per_capita_index, mayo 2026.
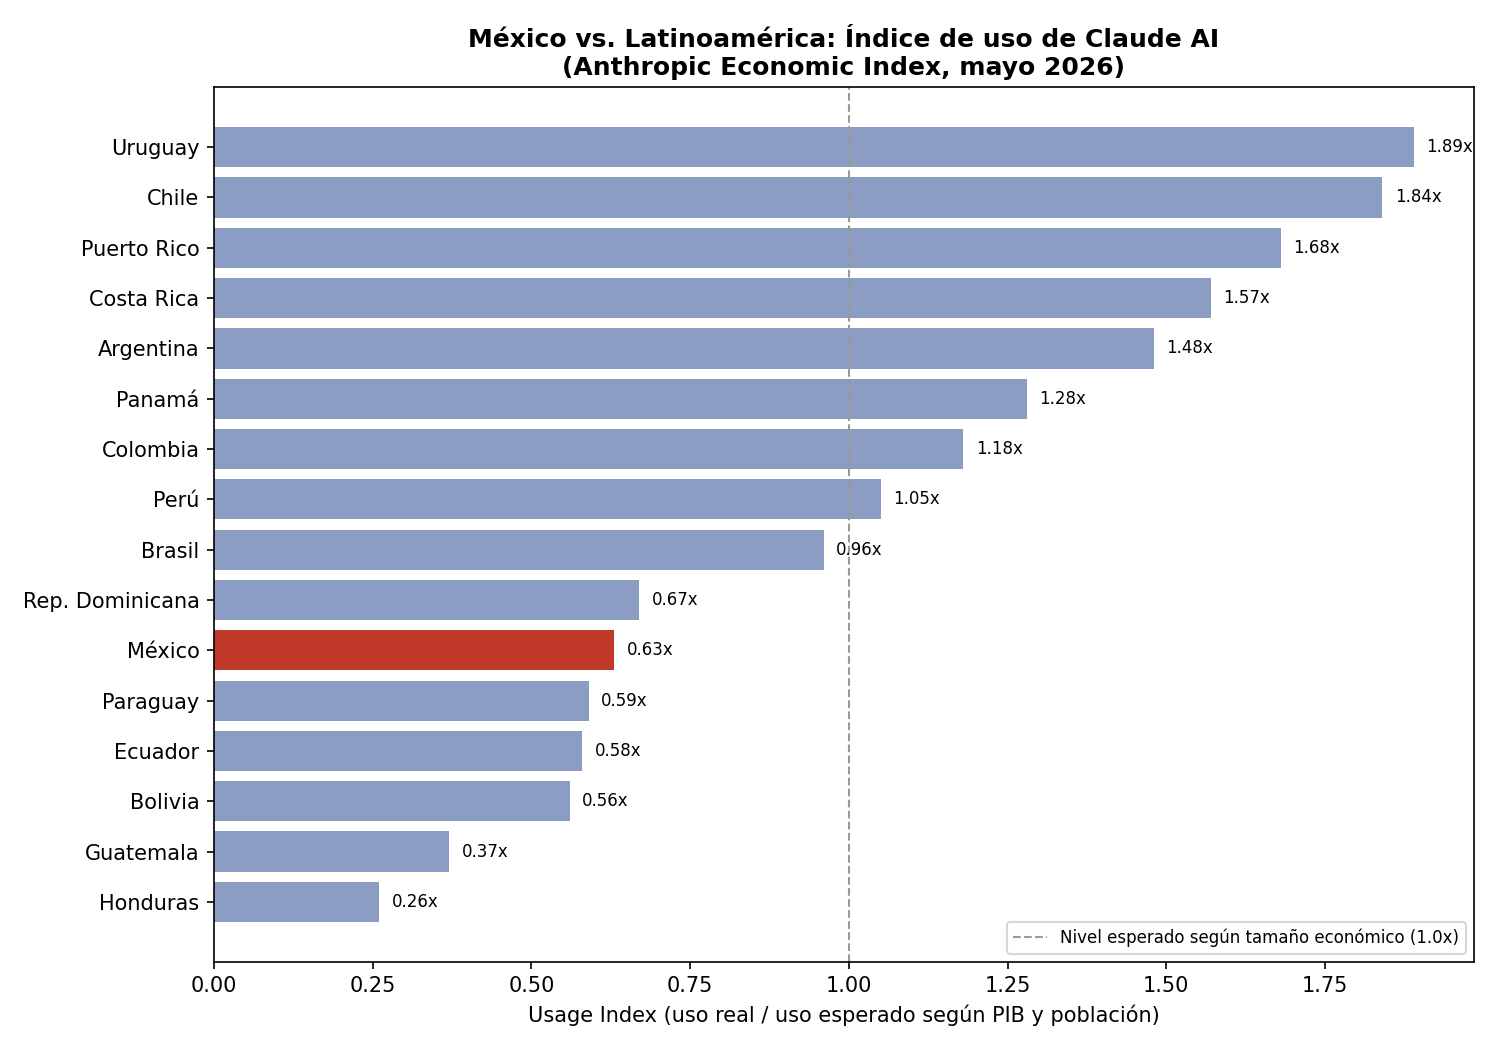
De las 16 economías latinoamericanas con datos, diez superan a México en el índice: Uruguay, Chile, Puerto Rico, Costa Rica, Argentina, Panamá, Colombia, Perú, Brasil y República Dominicana. Las seis que quedan por debajo (Paraguay, El Salvador, Ecuador, Bolivia, Guatemala y Honduras) son todas economías considerablemente más pequeñas en tamaño total.
3.2.2 Perfil de uso comparado con economías menores de la región
La Tabla 3 compara el reparto entre uso de trabajo, uso personal y uso escolar entre México y tres economías latinoamericanas de menor tamaño total pero mayor índice de uso per cápita.
Tabla 3. Perfil de uso: México frente a economías menores con mayor índice de uso (mayo 2026)
| Índice de uso | Trabajo | Personal | Escolar | Modo automatización | |
|---|---|---|---|---|---|
| México | 0.63x | 45.0% | 34.0% | 21.1% | 50.4% |
| Colombia | 1.18x | 45.4% | 24.5% | 30.1% | 50.0% |
| Costa Rica | 1.57x | 45.5% | 33.3% | 21.2% | 48.9% |
| Perú | 1.05x | 36.2% | 22.0% | 41.9% | 47.6% |
Fuente: análisis propio sobre Anthropic Economic Index dataset [1], métricas usage_per_capita_index, use_case_work_pct, use_case_personal_pct, use_case_coursework_pct, collaboration_bucket_automation_pct.
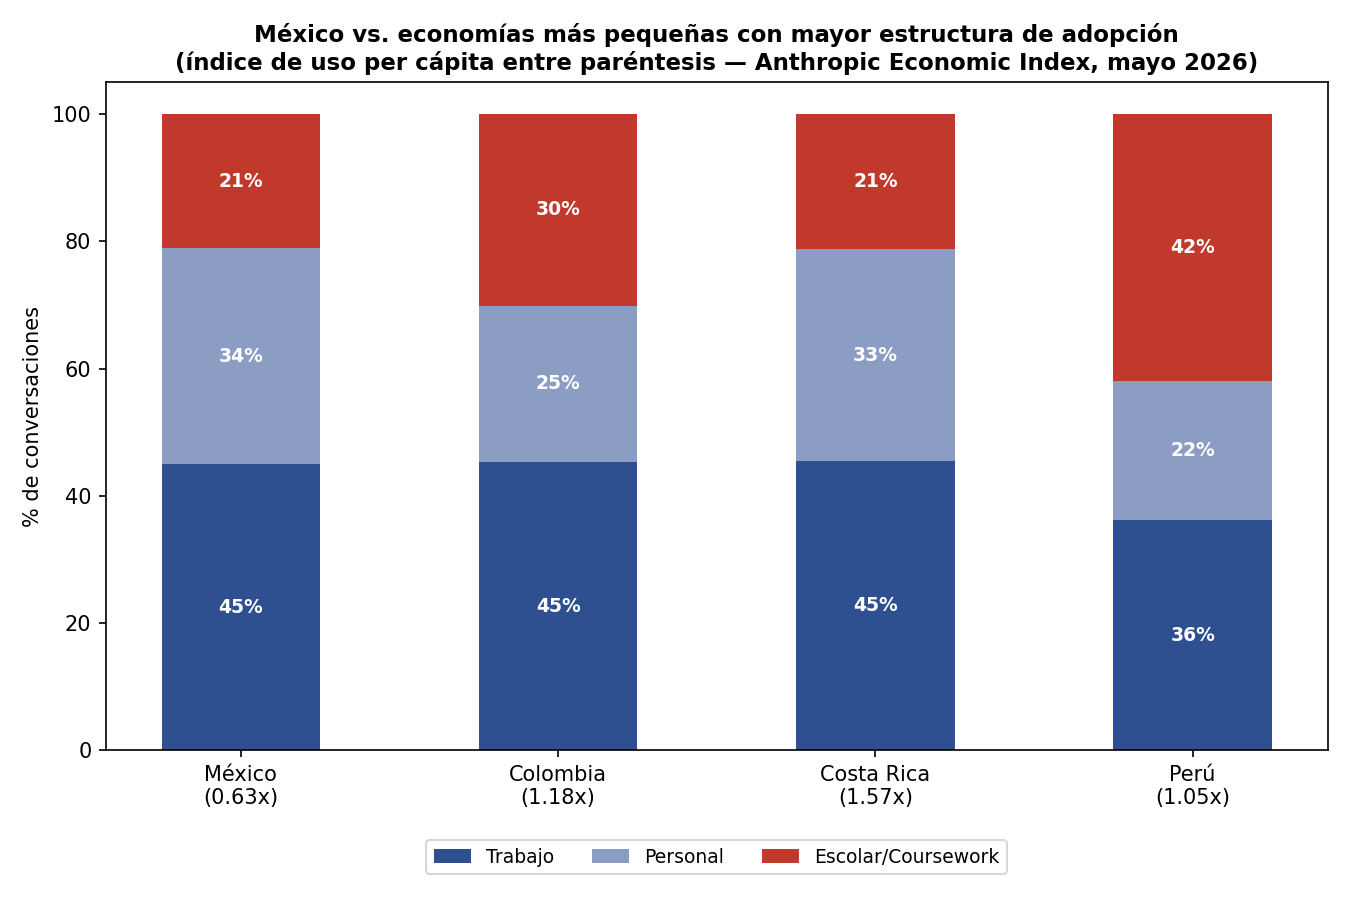
La proporción de uso de trabajo de México (45.0%) es prácticamente igual a la de Colombia (45.4%) y Costa Rica (45.5%), y superior a la de Perú (36.2%). El modo de automatización también se mueve en un rango estrecho entre las cuatro economías (47.6% a 50.4%). La proporción de uso escolar de México (21.1%) es la segunda más baja del grupo.
3.2.3 Desglose ocupacional del uso de trabajo en México
Al clasificar únicamente las conversaciones de trabajo contra la taxonomía de ocupaciones SOC, el panorama para México es el siguiente. La equivalencia de cada categoría con su nombre original en SOC está en el Anexo A.
Tabla 4. México: uso de Claude por categoría ocupacional (mayo 2026)
| Categoría ocupacional | % del uso de trabajo |
|---|---|
| Informática y matemáticas | 24.90% |
| Arte, diseño, entretenimiento, deportes y medios | 13.18% |
| Educación y bibliotecas | 11.58% |
| Ventas y afines | 8.67% |
| Apoyo administrativo y de oficina | 8.35% |
| Dirección y gerencia | 6.89% |
| Operaciones de negocio y finanzas | 5.68% |
| Ciencias naturales y sociales | 4.35% |
| Arquitectura e ingeniería | 3.78% |
| Personal sanitario y técnico | 3.37% |
| Servicios comunitarios y sociales | 2.25% |
| Cuidado personal y servicios | 1.24% |
| Jurídico | 1.16% |
| Producción | 1.12% |
| Apoyo sanitario | 0.60% |
| Instalación, mantenimiento y reparación | 0.50% |
| Preparación y servicio de alimentos | 0.46% |
| Transporte y movimiento de materiales | 0.35% |
| Servicios de protección | 0.28% |
| Limpieza y mantenimiento de inmuebles | 0.14% |
Fuente: análisis propio sobre Anthropic Economic Index dataset [1], categoría soc_occupation, jerarquía nivel 1, México, mayo 2026.
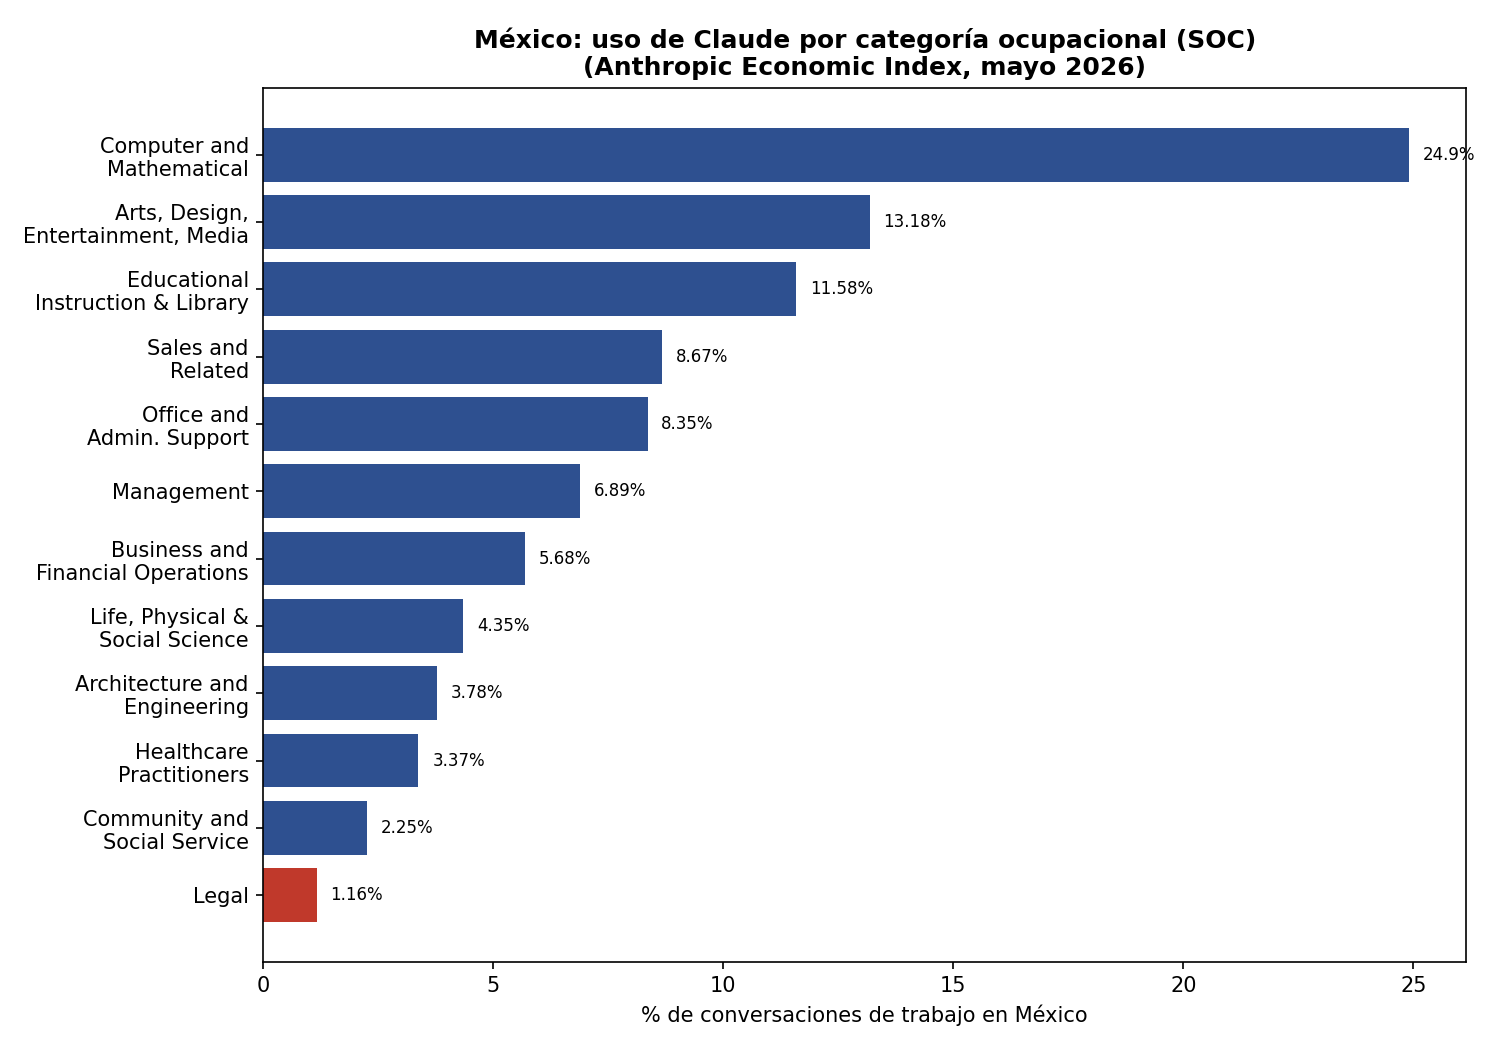
Una sola categoría técnica, Informática y matemáticas, concentra 24.90% del uso de trabajo. Las tres primeras categorías suman 49.66%. Las categorías profesionales de mayor complejidad de proceso registran participaciones de un dígito bajo: Operaciones de negocio y finanzas 5.68%, Jurídico 1.16%.
Al desglosar los temas específicos de conversación (no las categorías ocupacionales, sino los "temas"), "Homework" (tareas escolares) es el tema individual más frecuente de todos en México, con 7.89%, por encima de "Business operations" (operaciones de negocio) con 4.63% y de "Starting a business" (emprender un negocio) con 3.28% [1]. Este tema no es particular de México (Sección 3.2.6).
3.2.4 Los cinco estados con mayor adopción
Al desglosar el uso por entidad federativa (25 de 32 estados cuentan con datos suficientes para pasar el umbral de privacidad del dataset):
Tabla 5. Los 5 estados mexicanos con mayor participación en el uso nacional de Claude (mayo 2026)
| Estado | % del uso nacional | Trabajo | Personal | Escolar |
|---|---|---|---|---|
| Ciudad de México | 35.05% | 46.90% | 34.15% | 18.95% |
| Nuevo León | 9.37% | 44.82% | 32.55% | 22.63% |
| Jalisco | 8.63% | 47.84% | 33.15% | 19.00% |
| Estado de México | 4.11% | 40.16% | 33.21% | 26.62% |
| Puebla | 3.82% | 40.14% | 29.54% | 30.32% |
Fuente: análisis propio sobre Anthropic Economic Index dataset [1], geo_level subregion, métrica usage_pct y variables de caso de uso, mayo 2026.
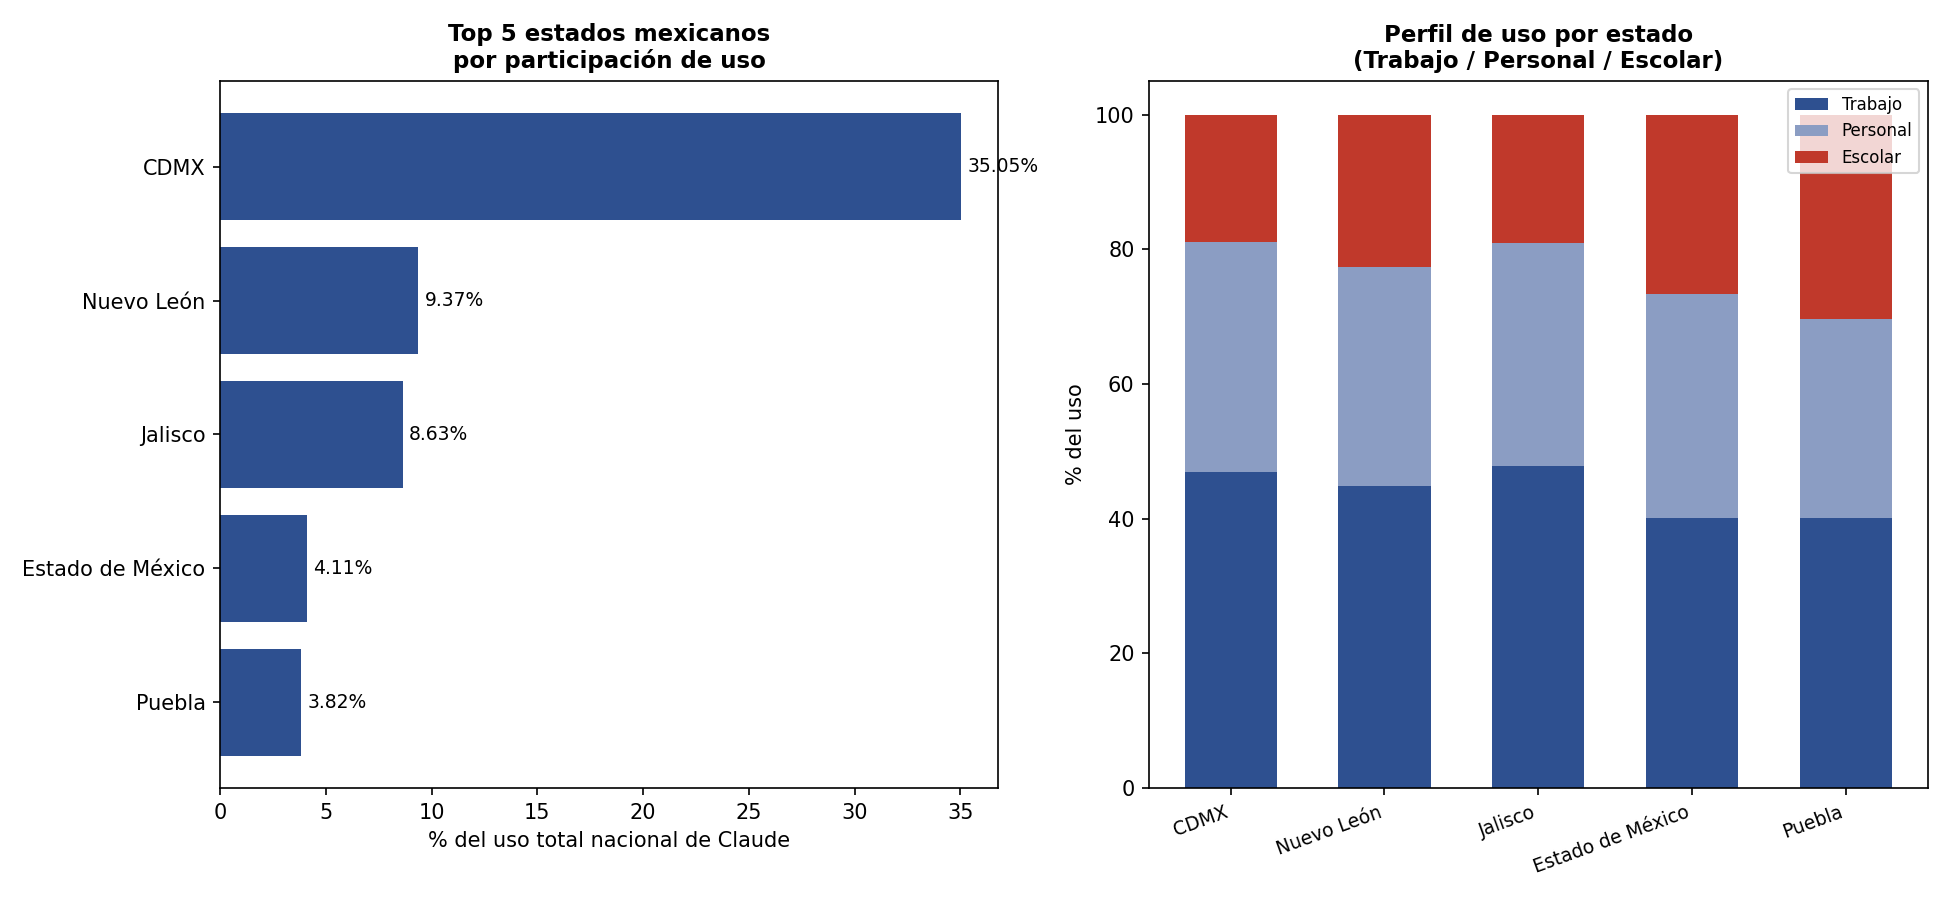
Ciudad de México concentra 35.05% de todo el uso nacional, más que los siguientes tres estados sumados (22.11%). Los cinco estados juntos representan 60.98%.
Tabla 6. Desglose ocupacional comparado entre los 5 estados líderes (mayo 2026)
| Categoría | CDMX | Jalisco | Edo. Méx. | Nuevo León | Puebla |
|---|---|---|---|---|---|
| Informática y matemáticas | 23.67% | 25.53% | 25.72% | 25.59% | 26.26% |
| Arte, diseño, entretenimiento y medios | 13.02% | 12.07% | 15.15% | 12.47% | 14.49% |
| Educación y bibliotecas | 12.00% | 9.97% | 12.44% | 11.15% | 12.02% |
| Apoyo administrativo y de oficina | 8.89% | 8.62% | 7.98% | 8.10% | 8.43% |
| Ventas y afines | 8.60% | 8.77% | 8.39% | 9.21% | 6.44% |
| Dirección y gerencia | 6.82% | 7.32% | 6.15% | 6.62% | 6.47% |
| Operaciones de negocio y finanzas | 5.97% | 6.07% | 4.33% | 5.95% | 5.64% |
| Jurídico | 1.16% | 1.33% | 0.95% | 1.17% | 1.16% |
Fuente: análisis propio sobre Anthropic Economic Index dataset [1], categoría soc_occupation, jerarquía nivel 1, mayo 2026.
El rango de variación de la categoría dominante entre los cinco estados es de 2.59 puntos porcentuales (23.67% a 26.26%). El orden de las ocho categorías es idéntico en los cinco estados salvo por el intercambio entre Ventas y Apoyo administrativo.
3.2.5 El índice ajustado por ingreso
Como el índice no incorpora ingreso, la pregunta de si México rezaga dado su ingreso se responde ajustando. Se regresó log(índice de uso) contra log(PIB 2024 por persona de 15 a 64 años) en 120 países (scripts/tesis/ajuste-ingreso.py). El ingreso explica 84.5% de la varianza internacional del índice (r = 0.919, n = 120). El residuo de México es −0.55 en logaritmo natural: usa 0.58 veces lo que su ingreso predice, y queda en el lugar 109 de 120 por residuo, peor que su lugar 76 de 121 sin ajustar.
Tabla 9. Índice de uso e ingreso: México y economías de referencia (mayo 2026)
| País | Índice de uso | PIB por persona de 15 a 64 años (USD, 2024) | Residuo (ln) | Lugar por residuo (de 120; 1 = mayor) |
|---|---|---|---|---|
| México | 0.63 | 21,055 | −0.55 | 109 |
| Argentina | 1.48 | 20,966 | +0.31 | 28 |
| Chile | 1.84 | 24,249 | +0.42 | 21 |
| Colombia | 1.18 | 11,314 | +0.55 | 12 |
| Perú | 1.05 | 12,646 | +0.35 | 25 |
| Brasil | 0.96 | 14,783 | +0.14 | 47 |
| Costa Rica | 1.57 | 26,952 | +0.18 | 40 |
| Uruguay | 1.89 | 36,408 | +0.14 | 48 |
Fuente: análisis propio sobre Anthropic Economic Index [1] y PIB y población de 15 a 64 años de 2024 (archivos de trabajo; la fuente primaria de estas dos series está por confirmar). PIB en dólares corrientes, no en paridad de poder adquisitivo.
El residuo de México equivale a −1.29 desviaciones estándar de los residuos (SD = 0.43 en logaritmo): cerca de 10% de los países con su ingreso tendría un índice igual o menor. El ingreso de México predice 0.63 / 0.58 = 1.09x, y el valor observado de 0.63 cae dentro del intervalo de predicción de 95% (0.47 a 2.53). Es un rezago consistente y de tamaño apreciable, pero no una anomalía estadística aislada.
Con casi el mismo ingreso por persona en edad de trabajar que Argentina (21,055 contra 20,966 dólares), México usa 0.63x contra 1.48x. Colombia, con aproximadamente la mitad del ingreso, usa 1.18x.
3.2.6 "Homework" y artefactos de oficina en el resto del mundo
"Homework" es el tema individual más frecuente en 99 de 121 países y en el agregado global (6.41%). Entre los 121 países, su participación correlaciona negativamente con el índice de uso (ρ de Spearman = −0.62, p < 1e-13). En la región, Perú (15.80%), Colombia (11.17%), Chile (9.60%), Costa Rica (9.37%) y Argentina (9.26%) tienen más Homework que México (7.89%) y más índice de uso.
Para la medida directa de "aceleración de artefactos" se sumó la participación de documento o reporte, presentación y hoja de cálculo o datos, que el dataset publica por país.
Tabla 10. Homework, artefactos de oficina y automatización: México y referencias (mayo 2026)
| País | Homework | Artefactos de oficina | Modo automatización | Índice de uso |
|---|---|---|---|---|
| Global | 6.41% | 20.3% | 48.6% | 1.00 |
| México | 7.89% | 24.6% | 50.4% | 0.63 |
| Chile | 9.60% | 26.2% | 48.8% | 1.84 |
| Colombia | 11.17% | 29.7% | 50.0% | 1.18 |
| Perú | 15.80% | 30.0% | 47.6% | 1.05 |
| Brasil | 4.40% | 25.2% | 51.2% | 0.96 |
| Argentina | 9.26% | 21.1% | 47.9% | 1.48 |
| Costa Rica | 9.37% | 21.8% | 48.9% | 1.57 |
Fuente: análisis propio sobre Anthropic Economic Index [1] (scripts/tesis/homework-y-artefactos.py).
México está por encima del agregado global en artefactos de oficina (percentil 79 de 121) y por debajo de Chile, Brasil, Colombia y Perú.
3.3 Desigualdad entre estados: líderes contra rezagados
Los cinco estados con menor participación en el uso nacional de Claude, de los 25 con datos disponibles, son Chiapas, Tabasco, Morelos, Oaxaca y Aguascalientes.
Tabla 7. Los 5 estados mexicanos con menor participación en el uso nacional de Claude (mayo 2026)
| Estado | % del uso nacional | Amplitud ocupacional (categorías SOC observadas, de 20) |
|---|---|---|
| Chiapas | 0.76% | 8 |
| Tabasco | 0.81% | 8 |
| Morelos | 0.90% | 9 |
| Oaxaca | 0.94% | 10 |
| Aguascalientes | 1.01% | 11 |
Fuente: análisis propio sobre Anthropic Economic Index dataset [1], geo_level subregion, mayo 2026. La "amplitud ocupacional" cuenta cuántas de las 20 categorías SOC de nivel 1 superan el umbral mínimo de usuarios que el propio dataset exige para reportar un valor (protección de privacidad).
Tabla 8. Comparación de promedios: 5 estados líderes contra 5 rezagados
| Top 5 (CDMX, NL, Jal., Edo. Méx., Puebla) | Bottom 5 (Chiapas, Tabasco, Morelos, Oaxaca, Aguascalientes) | |
|---|---|---|
| % del uso nacional (promedio) | 12.2% | 0.9% |
| Amplitud ocupacional (promedio, de 20) | 16.8 | 9.2 |
| Uso de trabajo | 44.0% | 42.8% |
| Uso personal | 32.5% | 33.5% |
| Uso escolar | 23.5% | 23.7% |
Fuente: análisis propio sobre Anthropic Economic Index dataset [1], mayo 2026.
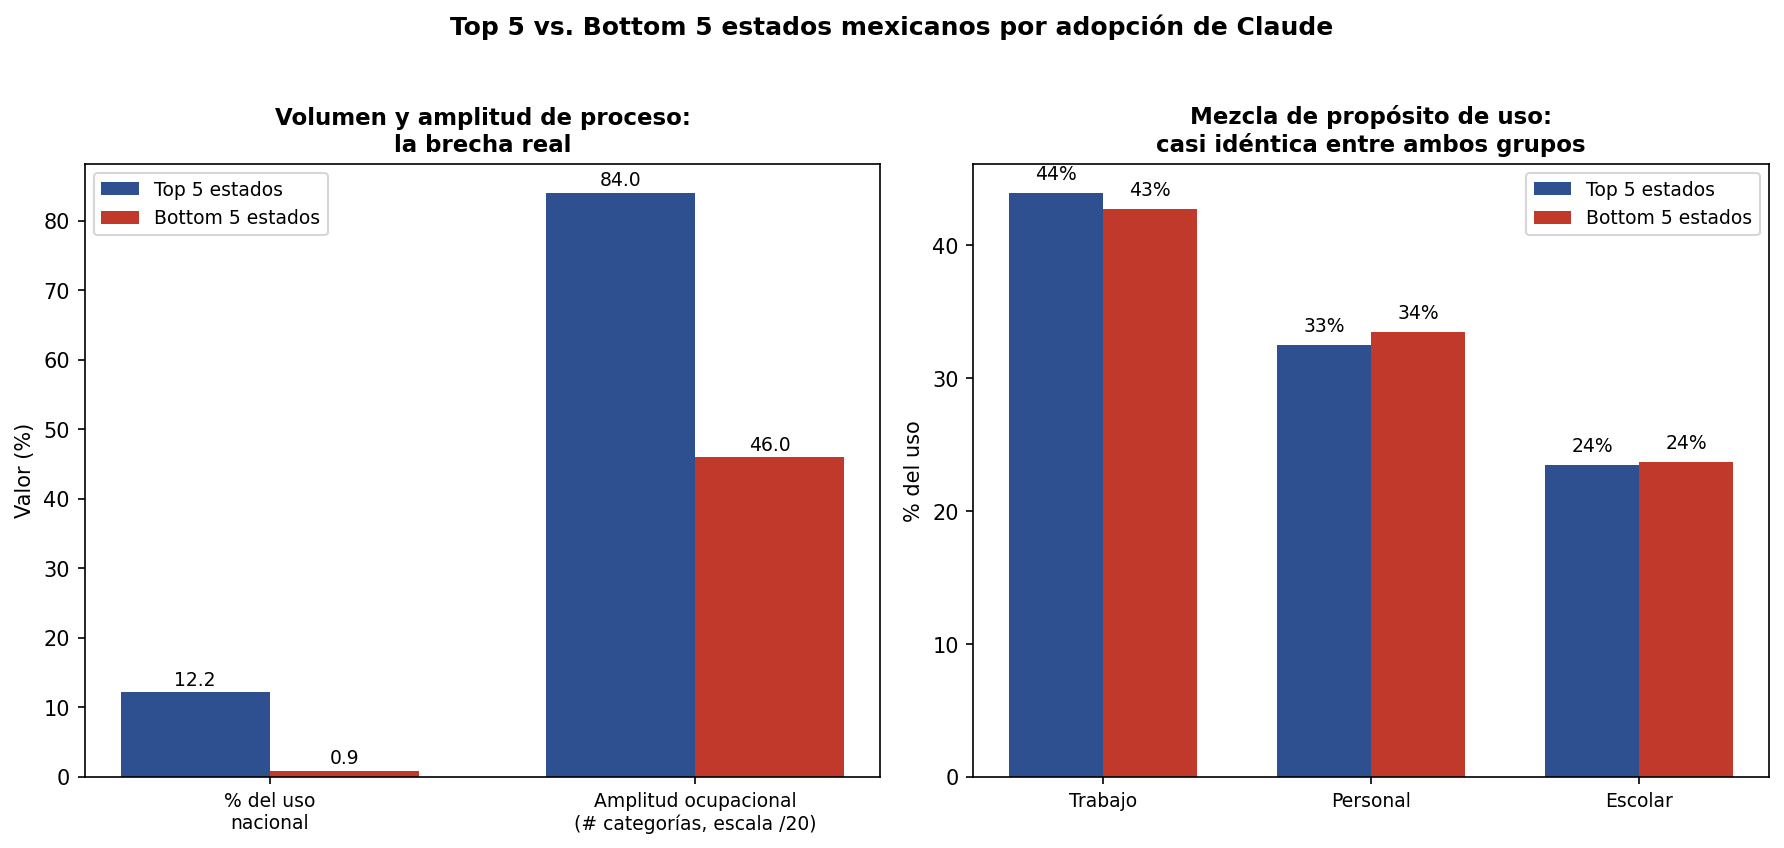
Las diferencias entre ambos grupos son de magnitud muy distinta según la variable. En mezcla de propósito las diferencias son de 1.2 puntos porcentuales o menos: uso de trabajo 44.0% contra 42.8%, uso personal 32.5% contra 33.5%, uso escolar 23.5% contra 23.7%. En volumen la razón es de 13.6 a 1 (12.2% contra 0.9%), y en amplitud ocupacional de 1.8 a 1 (16.8 contra 9.2 categorías de 20), cifra que se conserva solo como descripción: la diferencia de amplitud se retiró como hallazgo el 12 de octubre de 2026 porque una simulación sin diferencias reales entre estados la reproduce (Sección 3.3 y Anexo A).
Extendiendo la medición a los 25 estados con datos, y no solo a los diez extremos:
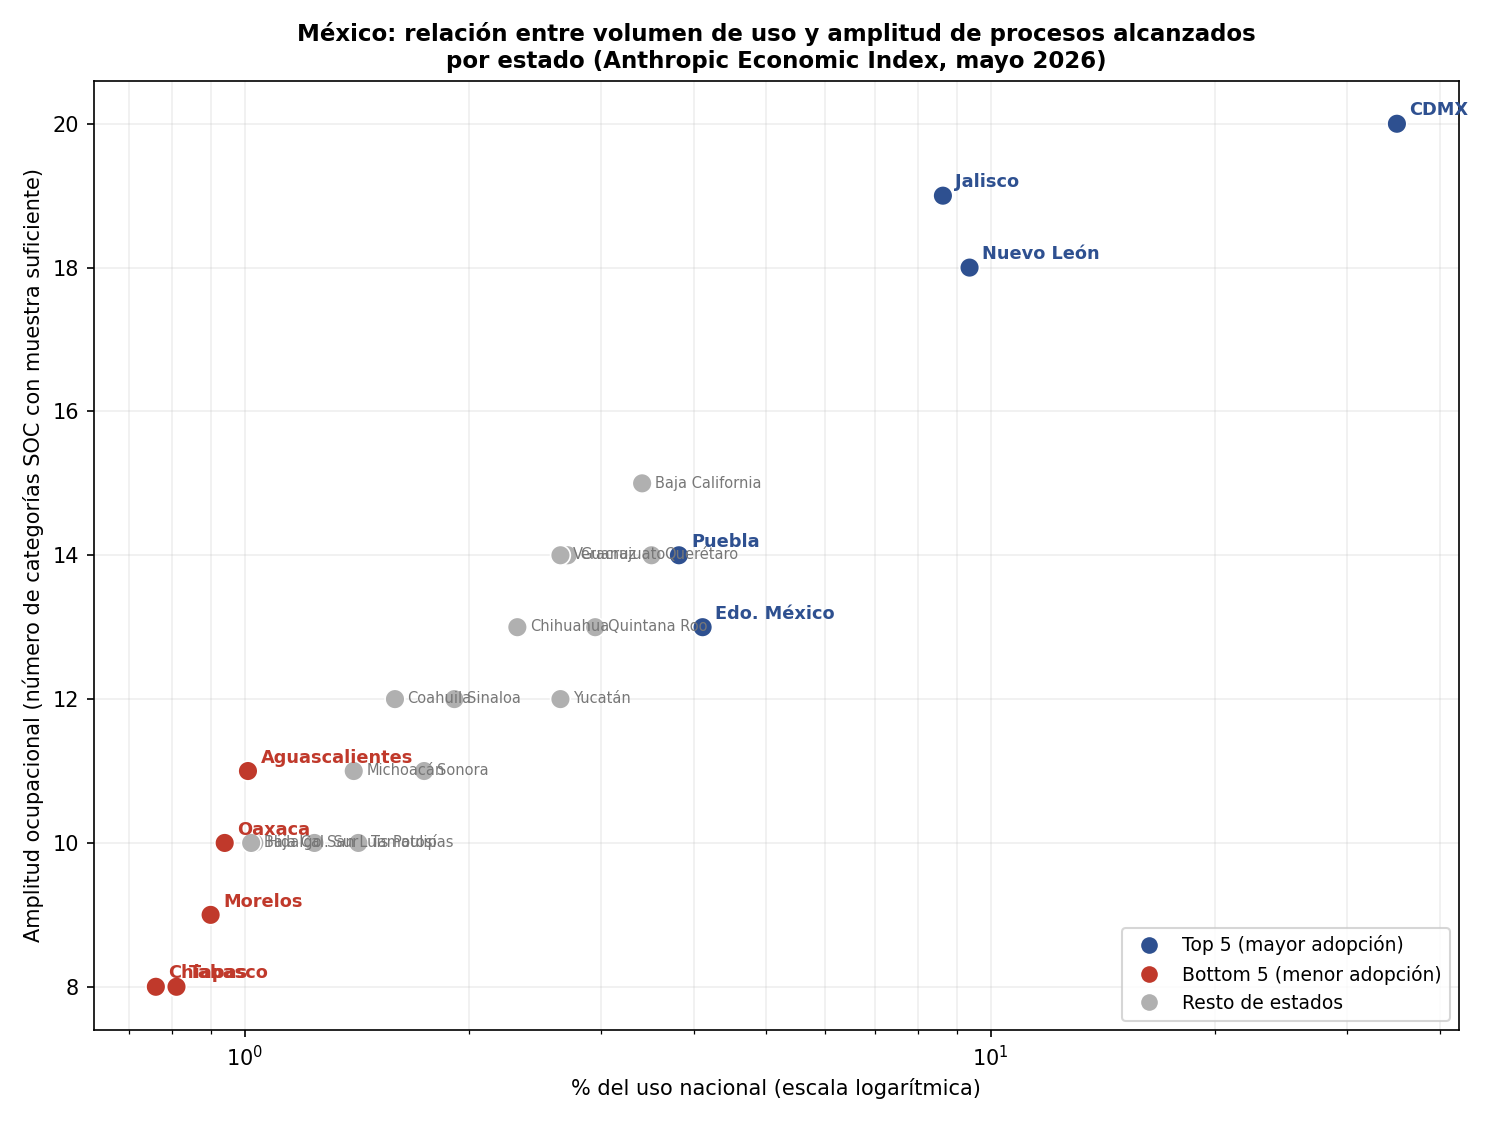
La relación entre volumen de uso y amplitud ocupacional es positiva y casi perfecta: r de Pearson = 0.957 (p < 0.0001, n = 25) sobre el volumen en escala logarítmica, y ρ de Spearman = 0.944 [1]. Este resultado ya no se interpreta como evidencia de adopción. El gráfico se conserva solo como descripción.
Se simuló la hipótesis nula más dura. Los 25 estados comparten exactamente la mezcla ocupacional nacional de la Tabla 4 (cero diferencia real de amplitud) y solo difieren en volumen. La amplitud de cada estado es el número de categorías cuyo conteo supera un umbral de publicación. Con dos parámetros libres (tamaño nacional y umbral), ajustados contra el vector observado, el modelo reproduce la amplitud con un error medio de 0.57 categorías de 20 y produce r = 0.961 (IC 95% 0.942 a 0.976; 5,000 réplicas). El r observado cae dentro de ese intervalo, en el percentil 32 de la distribución (scripts/tesis/nulo-amplitud.py). La revisión externa que hizo la misma prueba con su propia implementación obtuvo r = 0.959 (IC 95% 0.938 a 0.976). El método de cálculo del r observado está en el Anexo A.
3.4 Adopción organizacional según el INEGI
Los datos de uso de plataformas de IA (Sección 3.2) miden comportamiento de personas individuales. Para adopción organizacional, la fuente disponible es la estadística oficial.
Los Censos Económicos 2024 del INEGI [10], con año de referencia 2023, encontraron que 1,444,950 de las 5,451,113 unidades económicas del sector privado y paraestatal usaron internet para sus actividades y que 1,266,352 de ellas usaron herramientas digitales. De esas 1,266,352, 2.1% reportó usar sistemas de inteligencia artificial: 26,093 unidades. Esa es la cifra que publica el INEGI. Dividida entre el total de 5,451,113 unidades, incluidas cerca de cuatro millones que no usan internet, equivale a 0.5%; ese 0.5% es un cálculo propio y no una cifra censal publicada.
Versiones anteriores de este documento reportaron además cerca de 4.8% en manufactura, 0.7% en comercio, 7.8% en medianas manufactureras y 1.2% en pequeñas. Su base de cálculo (total de unidades o unidades con herramientas digitales) no se pudo confirmar contra el comunicado, por lo que se dejan como pendientes de verificar y no se usan en el argumento.
Las encuestas de proveedores tecnológicos reportan cifras de 60% o más de "incorporación de IA" entre PyMEs mexicanas. Las cifras miden objetos distintos. El INEGI censa a todas las unidades, incluidas las que no usan internet, y pregunta por sistemas de IA (definición censal). Las encuestas de proveedores miden si alguien en la empresa ha usado alguna herramienta de IA, con muestras autoseleccionadas que no incluyen a las unidades sin conexión.
En sentido contrario, el Banco de México levantó en junio de 2026 un módulo especial de la EMAER sobre establecimientos de más de 100 trabajadores: 48.5% reportó usar al menos una tecnología de IA y 64.8% espera usarla en tres años [16]. Es una cifra de banco central, de otra población (establecimientos grandes) y de una fecha posterior al censo. Se verificó en el recuadro original del Reporte sobre las Economías Regionales: 43.7% entre los establecimientos de 101 a 250 trabajadores, 69.9% entre los de más de 1,000, y 67.5% reporta que la IA no tuvo un efecto significativo en su empleo en los últimos tres años [16].
El estudio "México Inteligente" del Centro México Digital [11], con base en los mismos Censos Económicos 2024, reporta que en manufactura, por cada 10 puntos porcentuales de incremento en adopción de IA, la producción bruta por unidad económica crece 18.8%, los salarios 5.4% y el empleo 3.3%. Es una correlación observada en datos censales, no una relación causal establecida. La manufactura genera 20% del PIB mexicano y 90% de sus exportaciones.
3.5 Profundidad de uso: OpenAI/NBER y Google ATLAS
El estudio de OpenAI y NBER [4], sobre 1.5 millones de conversaciones de cuentas de consumo de ChatGPT, reporta que más de 70% del uso de ChatGPT no está relacionado con trabajo. Del 30% que sí lo está, "escritura" (redacción y edición de contenido) es la tarea más común, seguida de "guía práctica" y "búsqueda de información"; "asistencia técnica" (código) cayó de 18% a 10% del uso de trabajo en un año. El estudio no incluye desglose para México.
El reporte de Google [5] aporta cuatro resultados relevantes, todos globales:
- Profundidad de uso: en la ocupación mediana con algún uso de IA, esta se aplica a 21% del total de tareas de esa ocupación. Solo 3% de las ocupaciones muestra uso de IA en más de 75% de sus tareas.
- Automatización de punta a punta: representa menos del 10% de las conversaciones de trabajo en tareas cognitivas no rutinarias. La mayor parte del uso se concentra en "Redacción y Generación Parcial", "Revisión y Refinamiento", "Ideación y Estrategia" e "Información y Aprendizaje".
- Relación con ingresos: un incremento de 1% en el salario mediano de una ocupación se asocia con más de 2.5% de mayor intensidad de uso de IA.
- Uso fuera del trabajo: más del 86% de las interacciones ocurre en tiempo no laboral, concentradas en ocio y socialización (26.4%) y educación (20.7%).
Comparando países OCDE contra no-OCDE, Google [5] encuentra que el uso en países no-OCDE se concentra más en "Apoyo administrativo y de oficina" y "Arte, diseño, entretenimiento y medios", mientras el uso en países OCDE se concentra más en "Informática y matemáticas" y "Operaciones de negocio y finanzas". México no aparece desglosado individualmente.
3.6 Percepción declarada de quienes usan IA
La encuesta que acompaña al Anthropic Economic Index (aproximadamente 9,700 respuestas vinculadas a datos de uso real, mayo-junio 2026) reporta [2]:
- 86% declara ganancias en velocidad, 82% en alcance del trabajo que puede abarcar, 69% en calidad.
- 10% califica como probable o muy probable perder su propio empleo en el próximo año por causa de la IA. La preocupación declarada por colegas junior es sistemáticamente mayor: más de un tercio estima en más de 60% la probabilidad de que un colega junior pierda su empleo en el próximo año.
- Quienes delegan tareas completas a la IA (uso más automatizado) declaran mayor optimismo sobre el efecto de la IA en su salario, seguridad laboral y desarrollo profesional que quienes la usan de forma colaborativa.
- 68% declara que aprende más usando IA y 57% que sus habilidades se volvieron más valiosas en el mercado laboral. El propio estudio señala que son autopercepciones, no mediciones objetivas.
3.7 Proveedores excluidos del análisis
Se verificó mediante búsqueda directa si xAI (Grok), DeepSeek y Moonshot AI (Kimi) publican estudios económicos equivalentes a los tres anteriores. No existe ningún estudio primario de estos tres laboratorios con metodología comparable. Lo único disponible públicamente son estimaciones de terceros sobre tráfico web y descargas de aplicaciones, que miden popularidad y cuota de mercado. Estos tres proveedores quedan excluidos del análisis comparativo.
3.8 Qué no permite afirmar este corte de datos
El dataset usado para el análisis de México (Secciones 3.2 y 3.3) cubre dos periodos mensuales (abril y mayo de 2026), en los que el índice de uso per cápita de México pasó de 0.60 a 0.63, un incremento de 5% en un mes. Dos puntos de datos no constituyen una tendencia, y este documento no proyecta una trayectoria a partir de ellos.
Para el mediano plazo, McKinsey y BCG documentan un ritmo de adopción organizacional que se ha acelerado año con año desde 2023 [6], [7], y ambas fuentes reportan que la proporción de organizaciones que captura valor (5-12%) no ha crecido al mismo ritmo que la proporción que usa IA (88%+). Se citan explícitamente como proyecciones de tercero, no como hechos observados en este análisis.
4. Discusión
Esta sección interpreta los resultados de la Sección 3. A diferencia de aquella, aquí hay lectura del autor, y aplica el conflicto de interés declarado en la Sección 1.2.
4.1 Herramienta contra proceso: el argumento central
Los resultados de la Sección 3 admiten una lectura articulada en cuatro pasos.
Primero: a nivel global, entre 88% y 90%+ de las organizaciones ya "usa IA" en algún sentido [6]. Esa cifra ya no es informativa por sí sola, porque prácticamente cualquier definición razonable de "uso" está saturada.
Segundo: de ese universo, solo entre 5% y 12% captura valor financiero real [6]–[9], y lo que mejor predice la diferencia no es qué modelo se usa, sino si la organización rediseñó su flujo de trabajo alrededor de la nueva capacidad [6], y si invirtió en las personas y los procesos y no solo en la tecnología [7].
Tercero: incluso donde hay adopción activa, la profundidad del uso es baja: la ocupación mediana con algún uso de IA lo aplica a 21% de sus tareas [5], y la automatización de punta a punta es menos de 10% de las interacciones cognitivas no rutinarias [5]. (Versiones anteriores sumaban aquí que "Homework" es el tema más común en México; se retiró porque lo es en 99 de 121 países.) Es uso que cuenta en las estadísticas de adopción sin representar un cambio de proceso de negocio.
Cuarto: en México, la distancia entre "uso alguna vez" (60%+ según proveedores) y "sistema de IA integrado a la operación" (2.1% de las unidades con herramientas digitales, 0.5% del total, según el INEGI) [10] es consistente con el mismo fenómeno, pero no es solo de definición. Las encuestas de proveedores no muestrean a las unidades sin internet, y el censo refiere a 2023 en una tecnología que se movió rápido después. La cifra de Banxico (48.5% en establecimientos de más de 100 trabajadores, junio de 2026) [16] indica que, al menos en empresas grandes, el rezago temporal pesa más de lo que una versión anterior de este documento suponía.
De ahí la formulación que da nombre al documento: una hoja de cálculo hecha más rápido con IA sigue siendo una hoja de cálculo, no un proceso. Un documento generado en segundos sigue siendo un documento, no la reingeniería de la actividad que ese documento debía apoyar. La aceleración de artefactos existentes es visible, fácil de demostrar en una demo, y es lo que las herramientas genéricas de IA hacen mejor. El rediseño de proceso es invisible en una demo, requiere entender primero cómo opera el negocio, y es sistemáticamente lo que menos se hace, precisamente porque es más difícil y menos vistoso.
Conviene marcar el límite de esta lectura: la brecha del INEGI es un hecho; cuánto de ella es definición, cuánto población muestreada y cuánto rezago temporal es una pregunta abierta. La versión anterior afirmaba que era de definición y no de rezago; esa afirmación se retiró el 12 de octubre de 2026.
4.2 Qué explica la desigualdad entre estados
La Sección 3.3 no permite responder P3, y conviene decir por qué.
Lo que sí se observa es descriptivo. La mezcla de propósito de uso es prácticamente idéntica entre estados líderes y rezagados: diferencias de 1.2 puntos porcentuales o menos en las tres variables. Un chiapaneco y un capitalino que usan Claude lo usan para lo mismo, en la misma proporción. Lo que los separa es el volumen relativo, 13.6 veces mayor en el grupo líder.
Lo que no se puede afirmar es que la amplitud ocupacional mida adopción. La amplitud cuenta categorías que superan el umbral de privacidad del dataset, y un estado con más usuarios supera más umbrales por aritmética. La prueba del nulo de la Sección 3.3 lo muestra: sin ninguna diferencia real de amplitud entre estados, el modelo reproduce r = 0.961, y el r observado de 0.957 cae en el centro de esa distribución. El indicador no tiene poder para detectar diferencias de amplitud, ni grandes ni chicas.
Versiones anteriores leían r = 0.957 como una "masa crítica" de usuarios necesaria antes de que el uso se extienda, y afirmaban que ningún estado logra amplitud sin volumen. Esa lectura se retira. La advertencia que la versión anterior ya hacía (parte de la correlación es mecánica) resultó ser el caso completo y no una parte.
Consecuencia: la pregunta de qué separa a los estados queda sin respuesta en este documento. Un indicador con poder para contestarla necesitaría conteos de usuarios antes del umbral, o una tasa per cápita ajustada por el PIB estatal. La implicación de política pública que esta sección derivaba antes (acceso, acompañamiento, rediseño) ya no se sigue de estos datos.
4.3 Repercusiones económicas de la contradicción entre adopción declarada y real
La distancia entre cifras de adopción altas (60%+ según encuestas de proveedores) y adopción real baja (2.1% de las unidades con herramientas digitales según el INEGI [10]) no es solo un problema de medición. Tiene consecuencias plausibles:
- Mala asignación de capital. Una empresa (o un gobierno estatal) que decide su estrategia de inversión con base en cifras de adopción infladas puede sobrestimar qué tan preparado está su ecosistema y subestimar la inversión real necesaria en diagnóstico y rediseño antes de esperar retorno.
- Complacencia competitiva. Si una empresa cree, con base en encuestas optimistas, que "ya está usando IA igual que sus competidores", puede no percibir la urgencia de invertir en un rediseño genuino mientras competidores en estados o sectores con mayor amplitud sí lo hacen.
- Ampliación de una brecha ya documentada. Un artículo que sintetiza datos de PwC y del MIT documenta que 20% de las empresas captura 74% del valor económico generado por la IA a nivel global, con una brecha que se amplía [15]. Este documento no mide si el patrón se replica entre regiones dentro de México.
Sobre los posibles agravios de esta desigualdad, lo que sigue son hipótesis razonadas, no hechos establecidos: ninguna fuente de este documento midió directamente agravios causados por la brecha de adopción de IA dentro de México:
- Una brecha digital de segundo orden. Si el patrón se sostiene, los estados rezagados no solo tendrían menos acceso a la herramienta, sino menos procesos de negocio familiarizados con ella, lo que dificultaría cualquier intento futuro de adopción acelerada por falta de una base local de usuarios experimentados.
- Riesgo desproporcionado para trabajadores junior. Más de un tercio de los encuestados por Anthropic estima en más de 60% la probabilidad de que un colega junior pierda su empleo en el próximo año [2]. Si el acceso está geográficamente concentrado, es razonable anticipar que ese riesgo no se reparte de forma pareja entre regiones.
- La "carrera de dos velocidades" de Google ATLAS. El reporte plantea dos escenarios para la desigualdad salarial derivada de la IA: uno de "alcance", donde el acceso amplio permite que trabajadores menos experimentados se beneficien desproporcionadamente, y otro de "fuga hacia adelante", donde la adopción autoseleccionada y concentrada profundiza la brecha [5]. Los datos de este documento no permiten decidir entre los dos escenarios para México.
4.4 Costo de no adaptar y retorno de adaptar
La evidencia sobre el costo de no adoptar IA de forma efectiva es más escasa y más especulativa que la evidencia sobre adopción, y hay que presentarla con esa cautela. La fuente más citada es "Future of Professionals 2026" de Thomson Reuters (1,800 profesionales de sectores legal, fiscal, de auditoría y riesgos en 62 países), que estima que hasta 143,000 millones de dólares en ingresos ligados a servicios profesionales en Estados Unidos podrían quedar en riesgo por falta de capacidades de IA [14]. Es una estimación de riesgo declarado por encuestados, no una pérdida materializada, y se refiere a Estados Unidos, no a México.
Con esa salvedad, el mecanismo es conceptualmente transferible: en la medida en que los clientes de una PyME mexicana (sobre todo si son parte de cadenas de suministro con compradores más grandes o internacionales) esperen mayor velocidad, trazabilidad o capacidad analítica de sus proveedores, quienes no adapten sus procesos podrían perder competitividad relativa, independientemente de si el motivo declarado del cliente es "IA" o simplemente "mejor servicio".
Del lado del retorno, conviene la distinción entre ROI duro y ROI blando [13]. El duro cubre efectos ligados a rentabilidad: reducción de costos por automatización, eficiencia operativa, ingresos por capacidades nuevas. El blando incluye mejor toma de decisiones, retención de empleados y experiencia de cliente. La distinción importa porque buena parte de la frustración pública con la IA ocurre cuando se espera ROI duro inmediato de un uso que solo está generando ROI blando (o ninguno, si es aceleración de artefactos sin cambio de proceso). Las empresas que capturan ROI duro real, el 5-12% de la Sección 3.1, son casi sin excepción las que rediseñaron el proceso.
En cuanto a la correlación mexicana de manufactura [11] (18.8% más producción bruta por cada 10 puntos de adopción), la lectura inversa es que las unidades económicas dentro del 95.2% de la manufactura que no reporta uso de IA estarían dejando esa ganancia sobre la mesa. Pero es una correlación censal, no un experimento: es enteramente plausible que las empresas ya más productivas por otras razones sean también las que adoptan más fácilmente, en cuyo caso el 18.8% mide selección y no efecto.
4.5 Cómo la percepción condiciona la inversión en rediseño
Los datos de percepción de la Sección 3.6 importan aquí por una razón instrumental: la disposición de una organización a invertir en rediseño de proceso depende de cómo se siente su gente respecto a la herramienta.
El patrón que muestran (productividad autopercibida alta, preocupación laboral concentrada en terceros más que en uno mismo, y optimismo asociado al grado de delegación) es coherente con un clima de incertidumbre genuina más que con un consenso en cualquier dirección. La gente experimenta beneficios reales e inmediatos en su trabajo cotidiano y al mismo tiempo expresa dudas sobre las implicaciones estructurales de mediano plazo, sobre todo para quienes tienen menos trayectoria acumulada.
La correlación entre delegación y optimismo admite dos explicaciones opuestas y los datos no las separan: puede que usar la IA de forma más autónoma revele sus capacidades reales y eso genere optimismo, o puede que las personas ya optimistas sean las más dispuestas a delegarle tareas completas desde el principio.
El efecto humano y laboral de este clima, y la afirmación de que su causa es el abandono institucional y no la velocidad de la tecnología, se examinan en la tesis relacionada, Incertidumbre laboral y preparación de México ante la IA, que está marcada como abierta justamente porque ese vínculo causal no está establecido.
4.6 La dependencia estructural en las PyMEs mexicanas
El patrón de "herramienta sin proceso" no es exclusivo de la IA: es la continuación de un problema estructural más antiguo en las PyMEs mexicanas, la dependencia de personas clave en lugar de procesos sistematizados.
Hipótesis del autor, sin fuente primaria en este documento: el obstáculo más frecuente de las PyMEs mexicanas no es la falta de capital sino la ausencia de estructura organizacional: empresas que operan en modo supervivencia, sin procesos formales ni métricas, donde el crecimiento depende del esfuerzo y el conocimiento acumulado del fundador o de un puñado de empleados. Cuando esa persona se ausenta o se satura, no hay sistema que sostenga la operación.
El ERP genérico "todo en uno" suele presentarse como la solución, pero la hipótesis es que en la práctica sustituye una dependencia por otra: la de la persona clave por la del partner de implementación, sobre todo cuando la solución requiere personalización significativa, que es casi siempre el caso en una PyME cuyos procesos no siguen un estándar de industria. El Informe de Madurez Digital de AmCham/Needed Education [12] sitúa la madurez digital de las empresas mexicanas participantes en 41.7% en 2025 y 47% en 2026, todavía 22 puntos por debajo del nivel considerado ideal de mercado (70%).
Las versiones anteriores citaban dos blogs comerciales de implementadores de Odoo para el costo de los ERP; se retiraron el 12 de octubre de 2026 porque no son evidencia sobre PyMEs mexicanas. En conjunto, esto es coherente con la hipótesis de que el problema de fondo no es la falta de acceso a herramientas, de IA o de cualquier tipo, sino la falta de un diagnóstico honesto del proceso real antes de comprar cualquier solución.
4.7 Saturación del mercado de software y erosión de la diferenciación
Un fenómeno más reciente complica el panorama: la facilidad con la que hoy se construye software asistido por IA generativa ha reducido drásticamente el costo de crear una aplicación funcional, produciendo una proliferación de herramientas genéricas en categorías ya saturadas y erosionando la capacidad del comprador de distinguir una solución con entendimiento real del proceso de una construida rápidamente sin ese diagnóstico.
Para un comprador PyME esto tiene una consecuencia práctica: "tener una app con IA" deja de ser por sí mismo una señal de credibilidad. Aquí es donde el sesgo declarado en la Sección 1.2 pesa más, porque el paso siguiente del argumento (que esto refuerza el valor de un proveedor de diagnóstico-primero) es exactamente el interés comercial del autor. Se deja anotado como lo que es: una inferencia razonable, no un resultado.
4.8 Síntesis: la oportunidad de un modelo de diagnóstico-primero
Uniendo la evidencia:
- Hay una saturación real de uso de herramientas de IA a nivel individual, en México y globalmente, que ya no es informativa como métrica de adopción.
- Hay una brecha consistente, documentada en múltiples fuentes independientes con metodologías distintas [6]–[9], entre esa adopción superficial y la captura de valor real, y el factor que mejor la explica es el rediseño de proceso.
- México está por debajo de diez economías latinoamericanas en el índice de uso [1] y, ajustado por ingreso, entre los 12 peores de 120 países. Su adopción organizacional censal es de 2.1% de las unidades con herramientas digitales (0.5% del total), con año de referencia 2023 [10].
- La dependencia estructural de personas clave en las PyMEs, anterior a la IA, no se resuelve comprando una herramienta más; la hipótesis del autor, sin fuente primaria (Sección 4.6), es que frecuentemente se traslada a una nueva forma de dependencia.
- La saturación del mercado de software erosiona la credibilidad de cualquier oferta que no distinga entre construir rápido y entender primero.
La conclusión de mercado es que existe un espacio para una oferta de servicios y tecnología que anteponga el diagnóstico honesto del proceso al despliegue de tecnología: un modelo dispuesto a decir que la solución correcta es más simple o más barata de lo que el cliente imaginaba, y que mida su éxito en si el proceso del cliente cambió de verdad, no en si se instaló una herramienta más.
Esta es la conclusión sobre la que aplica de lleno el conflicto de interés de la Sección 1.2, y el lector debería tratarla como la parte más descontable del documento. Las Secciones 3 y 4.1 no dependen de ella.
4.9 Respuesta a las preguntas de investigación
P1. ¿La adopción reportada refleja adopción real de proceso, o uso superficial de herramienta? Mide predominantemente uso de herramienta. La respuesta se apoya en la baja profundidad de uso medida por Google (21% de las tareas de la ocupación mediana; menos de 10% de automatización de punta a punta) [5], en que solo 21% de los adoptantes rediseñó flujos [6] y en la distancia entre lo que declaran las encuestas de proveedores y la medición censal [10]. Se retiraron dos piezas de versiones anteriores: "Homework" como evidencia sobre México (es el tema número 1 en 99 de 121 países) y la afirmación de que la brecha del censo es de definición y no de rezago (Banxico midió 48.5% en establecimientos grandes en junio de 2026 [16]).
P2. ¿El rezago mexicano es frente al mundo o frente a su propia región? Frente a su propia región, y es el hallazgo mejor sostenido del documento. México está en 0.63x contra 1.0x del agregado global y por debajo de diez economías latinoamericanas [1]. El índice no ajusta por ingreso, así que se ajustó: el PIB por persona en edad de trabajar explica 84.5% de la varianza internacional del índice y, con ese control, México queda en el lugar 109 de 120. Con un ingreso casi igual al de Argentina usa 0.63x contra 1.48x, y Colombia, con la mitad del ingreso, usa 1.18x (Tabla 9). Se retira el argumento anterior de que la similitud del perfil de uso (Tabla 3) descarta el tamaño de la economía, porque la similitud de mezcla no dice nada sobre el nivel. El residuo de México (z = −1.29) queda dentro del intervalo de predicción de 95%: el rezago es consistente, no una anomalía estadística aislada. Sigue siendo un solo producto de un solo proveedor.
P3. ¿La desigualdad entre estados se explica por volumen, por tipo de uso, o por amplitud? Sin respuesta; se retiró el 12 de octubre de 2026. La versión anterior respondía "volumen y amplitud, no tipo de uso" apoyada en r = 0.957. Un modelo sin diferencias reales de amplitud produce r = 0.961 (IC 95% 0.942 a 0.976), así que el indicador no distingue adopción más ancha de umbral de privacidad. Lo único que se observa es descriptivo: la mezcla de propósito es casi idéntica entre estados líderes y rezagados. Qué explica la desigualdad estatal es una pregunta abierta, y la tesis relacionada la aborda con un indicador per cápita.
P4. ¿Qué distingue a las organizaciones que capturan valor? El rediseño del flujo de trabajo, por encima de cualquier otra variable medida. McKinsey lo identifica como el atributo con mayor correlación individual con impacto en EBIT entre 25 evaluados, y reporta que solo 21% de los adoptantes lo ha hecho [6]; BCG asigna 70% del esfuerzo necesario a personas y procesos contra 10% a algoritmos [7]. Las cuatro fuentes convergen en que entre 5% y 12% captura valor real [6]–[9].
5. Limitaciones del estudio
Es necesario declarar con la misma honestidad exigida al resto del documento cuáles son sus límites:
- El análisis de la Sección 3.2 mide uso de un solo producto (Claude), de un solo proveedor (Anthropic) [1]. No debe leerse como "el uso total de IA en México"; es una ventana parcial, aunque la más granular disponible por país para México específicamente.
- Ni el estudio de OpenAI [4] ni el de Google [5] ofrecen desglose para México, por lo que la comparación entre proveedores para el caso mexicano es necesariamente asimétrica: hay análisis profundo de Anthropic y solo contexto global de los otros dos.
- La comparación entre estados líderes y rezagados (Sección 3.3) se basa en un solo mes de corte (mayo 2026) y en un producto específico; no debe leerse como una medición de "desarrollo digital estatal".
- La correlación de r = 0.957 entre volumen y amplitud no es evidencia de adopción: la amplitud cuenta categorías que superan el umbral de privacidad, y un modelo sin diferencias reales de amplitud reproduce r = 0.961 (Sección 3.3). El hallazgo se retiró.
- Los datos duros mexicanos tienen fechas distintas: el censo refiere a 2023 y el análisis de Claude a abril y mayo de 2026. Se presentan como retrato aproximado y no como foto del mismo momento.
- El ajuste por ingreso (Sección 3.2.5) usa PIB en dólares corrientes y no en paridad de poder adquisitivo, un solo corte y un solo proveedor. El PIB y la población provienen de archivos de trabajo cuya fuente primaria está por confirmar.
- La cifra de Banxico (48.5%) se verificó en el recuadro original; falta comparar la misma población contra el censo, que no pregunta lo mismo.
- El indicador de amplitud ocupacional depende del mismo umbral: una amplitud baja puede reflejar tanto menor adopción real como un tamaño poblacional insuficiente para superarlo incluso con una tasa de adopción similar.
- La correlación entre adopción de IA y productividad en manufactura mexicana (Sección 3.4) [11] es observacional, no causal: es plausible que empresas ya más productivas sean también las que adoptan más fácilmente.
- El dataset de Anthropic [1] aplica umbrales de privacidad que excluyen 7 de los 32 estados mexicanos por tamaño de muestra insuficiente; los hallazgos por estado se limitan a los 25 con datos.
- Las cifras de adopción de encuestas de proveedores citadas con fines de contraste no fueron verificadas más allá de su presencia pública, y se presentan como contraste metodológico, no como dato validado.
- Las cifras de riesgo económico de la Sección 4.4 provienen de estudios de consultoras y medios que sintetizan encuestas a ejecutivos; son proyecciones y percepciones declaradas, no pérdidas materializadas.
- MIT NANDA [8] es, de las fuentes institucionales citadas, la de menor rigor metodológico relativo (no revisada por pares, muestra pequeña) y se cita únicamente como hallazgo consistente con fuentes más sólidas [6], [7], [9], nunca de forma aislada.
- El autor tiene un conflicto de interés declarado en la Sección 1.2. Afecta de forma directa a las Secciones 4.7 y 4.8, y de forma indirecta a la selección de qué preguntas se hicieron. No afecta a los datos de la Sección 3, que son verificables de forma independiente contra sus fuentes.
6. Trabajo futuro
Lo que este documento no pudo resolver, en orden de qué tanto cambiaría sus conclusiones:
1. Medir amplitud con un indicador que tenga poder. La prueba del nulo (Sección 3.3) mostró que la amplitud por umbral de privacidad no distingue adopción de volumen. Haría falta acceder a los conteos de usuarios por estado y categoría antes del umbral, o abandonar la amplitud y usar un índice per cápita ajustado por PIB estatal, como el que propone la tesis relacionada. Antes de publicar cualquier indicador nuevo se simula su nulo.
2. Establecer causalidad en la correlación del INEGI. El 18.8% de producción bruta adicional por cada 10 puntos de adopción [11] es hoy indistinguible de un efecto de selección. Un diseño de diferencias-en-diferencias sobre dos cortes censales, o un panel de unidades económicas que adoptaron en momentos distintos, permitiría separar efecto de selección. El siguiente corte de los Censos Económicos es la oportunidad natural.
3. Replicar el análisis mexicano con datos de OpenAI o Google. Es la vía directa para descartar que los hallazgos de la Sección 3.2 describan a la base de usuarios de Claude en vez de al país. Depende enteramente de que esos laboratorios publiquen desglose por país, algo que hoy ninguno de los dos hace. Si aparece y contradice el patrón, la Sección 8 explica qué se cae y qué no.
4. Medir profundidad de proceso directamente, no por proxy. Todo este documento infiere "rediseño de proceso" a partir de indicadores indirectos: amplitud ocupacional, proporción de tareas cubiertas, respuestas de encuesta. Un estudio de campo con un número acotado de PyMEs mexicanas, mapeando el proceso antes y después de introducir IA, mediría directamente lo que aquí solo se aproxima. Es el trabajo más caro y el más informativo.
5. Extender la serie temporal. Con seis o doce meses de cortes mensuales del Anthropic Economic Index se podría afirmar o descartar una tendencia para México, algo que con dos puntos (Sección 3.8) es imposible.
6. Confirmar la fuente primaria del PIB y la población usados en el ajuste por ingreso (el original de la EMAER de Banxico ya se verificó).
7. Conclusiones
- 01Sobre P1: lo que se reporta como adopción de IA en México mide predominantemente uso de herramienta, no rediseño de proceso. La narrativa de "adopción masiva de IA" y la de "la IA no está generando resultados" no son contradictorias: son la misma historia vista desde ángulos distintos, y ambas son ciertas simultáneamente porque miden cosas distintas.
- 02Sobre P2: México se ubica por debajo de sus pares regionales en uso real de IA, no solo por debajo del agregado global. Ajustado por ingreso la brecha es mayor (lugar 109 de 120), así que el ingreso por sí solo no la explica.
- 03Sobre P3: sin respuesta. La respuesta anterior (volumen y amplitud) se retiró porque el indicador de amplitud no distingue adopción de umbral de privacidad.
- 04Sobre P4: lo que distingue a las organizaciones que capturan valor financiero de la IA es haber rediseñado el flujo de trabajo, por encima de qué modelo usan o cuánto invierten. Solo 21% de los adoptantes lo ha hecho.
- 05La adopción organizacional de IA en México medida por el INEGI es marginal: 2.1% de las unidades que usan herramientas digitales (0.5% del total de unidades económicas, año 2023). Está muy por debajo de las cifras de las encuestas de proveedores, y parte de esa distancia es de población muestreada y de fecha, no solo de definición.
- 06La mezcla de uso de Claude es casi idéntica entre los estados mexicanos líderes y rezagados. Esa uniformidad no se interpreta como falta de profundidad de proceso, porque el dataset no la mide.
- 07La dependencia estructural de personas clave en las PyMEs mexicanas es un problema anterior y más profundo que la disponibilidad tecnológica, y las soluciones genéricas (de IA o de ERP) tienden, según la hipótesis del autor, a trasladar esa dependencia en lugar de resolverla cuando no van precedidas de un diagnóstico honesto del proceso real.
8. Qué la tumbaría
Toda tesis de este espacio cierra declarando qué evidencia la retiraría. La razón es simple: si no se puede nombrar el dato que haría cambiar de opinión al autor, lo que está escrito no es una tesis sino una opinión, y una opinión no se investiga porque ningún hallazgo la mueve. Esta sección es distinta de las Limitaciones (Sección 5): allí se declara lo que este estudio no alcanza a ver; aquí se declara lo que, de aparecer, obligaría a retirar la afirmación.
Lo que tumbaría el capítulo mexicano. Un desglose por país publicado por OpenAI o por Google para México en el que el uso no esté concentrado en aceleración de artefactos. Si eso aparece, el hallazgo de la Sección 3.2 no describe al país sino a la base de usuarios de Claude (que es una fracción del mercado total de IA), y todo el análisis original de este documento pasaría de ser un retrato de México a ser un retrato de quién usa Claude. Este es el riesgo más alto que corre el documento, y conviene decirlo sin adornos: la evidencia mexicana propia descansa sobre un solo proveedor.
Lo que tumbó el hallazgo de la desigualdad estatal (ocurrió el 12 de octubre de 2026). El criterio declarado era que, al controlar por tamaño de muestra, la correlación con el volumen se desplomara. No se desplomó: subió (r = 0.961 bajo el nulo contra 0.957 observado). El criterio se cumplió por la razón inversa a la esperada: el indicador no tiene poder para detectar diferencias de amplitud. La respuesta a P3 se retiró.
Lo que ese hallazgo NO tumbaría. El argumento central no se sostiene en Anthropic. El 2.1% del INEGI (Sección 3.4), el 21% de organizaciones que rediseñó flujos de trabajo según McKinsey (Sección 3.1) y el 21% de tareas por ocupación de Google ATLAS (Sección 3.5) son independientes de qué proveedor mida el uso. Si se borraran enteras las Secciones 3.2 y 3.3, la tesis de herramienta contra proceso seguiría en pie con esas tres piezas. La cifra del INEGI es independiente del proveedor, pero ya no se presenta como prueba de que la brecha sea de definición.
Lo que tumbaría la tesis completa. Que la brecha entre adopción declarada y adopción medida se cierre sin que ninguna de las dos haya cambiado qué mide: un corte nuevo de los Censos Económicos donde la adopción organizacional suba de 2.1% (de las unidades con herramientas digitales) hacia las cifras que reportan las encuestas de proveedores, con la misma definición censal de "sistema de IA integrado a la operación". Eso indicaría que la brecha era de rezago temporal (un fenómeno que el tiempo corrige solo) y no de definición, que es lo que una versión anterior de este documento afirmaba. Banxico ya midió 48.5% en establecimientos grandes en 2026, con otra población; si el próximo censo, con la misma definición, mostrara algo parecido para el universo completo, la brecha era de rezago.
9. Referencias
[1] Anthropic, "The Anthropic Economic Index," interactive dataset tool. Disponible en: https://www.anthropic.com/economic-index. Datasets aei_claude_ai_2026-06-26.csv y aei_1p_api_2026-06-26.csv, consultados el 26 de junio de 2026. El análisis de los datos crudos es trabajo original del autor.
[2] Anthropic, "Anthropic Economic Index Report: Cadences," 26 de junio de 2026. Disponible en: https://www.anthropic.com/research/economic-index-june-2026-report
[3] Anthropic, "The Anthropic Economic Index Report: New Building Blocks for Understanding AI Use." Disponible en: https://www.anthropic.com/research/economic-index-primitives
[4] A. Chatterji, T. Cunningham, D. J. Deming, Z. Hitzig, C. Ong, C. Y. Shan, y K. Wadman, "How People Use ChatGPT," National Bureau of Economic Research, Working Paper 34255, 2025. Disponible en: https://www.nber.org/papers/w34255
[5] Z. Iscenko, S. Strand, Y. Chen, G. Aimard, M. Codreanu, V. Sampathkumar, A. Imas, J. Jacobs, E. Muiruri, J. Mateos-Garcia, J. J. Ng, S. Javed, J. Martin, O. Ajmeri, D. Calin, A. Kim, F. Curto Millet, y J. Manyika, "Google's AI & Economy ATLAS v1.0: Mapping Gemini Usage in the Economy," Google y Google DeepMind, 23 de julio de 2026. Disponible en: https://ai.google/static/documents/GoogleATLASv1.pdf
[6] McKinsey & Company, "The State of AI: Global Survey 2025," McKinsey & Company, 2025.
[7] Boston Consulting Group, "The Widening AI Value Gap: Build for the Future 2025," Boston Consulting Group, 30 de septiembre de 2025.
[8] A. Challapally et al., "The GenAI Divide: State of AI in Business 2025," MIT NANDA, julio de 2025. Disponible en: https://mlq.ai/media/quarterly_decks/v0.1_State_of_AI_in_Business_2025_Report.pdf
[9] PricewaterhouseCoopers (PwC), "Global CEO Survey 2026," PwC, 2026.
[10] Instituto Nacional de Estadística y Geografía (INEGI), "Censos Económicos 2024," Comunicado de Prensa 79/25, 24 de julio de 2025.
[11] Centro México Digital, "México Inteligente: La Manufactura Frente a la Oportunidad que No Espera," con base en INEGI Censos Económicos 2024, presentado a la Secretaría de Economía, junio de 2026. Disponible en: https://www.stratego-st.com/publicaciones/la-oportunidad-de-la-inteligencia-artificial-que-la-manufactura-mexicana-deja-pasar/
[12] AmCham México y Needed Education, "Informe de Madurez Digital (IMD)," 2025–2026.
[13] I. Belcic y C. Stryker, "Cómo Maximizar el ROI de la IA en 2026," IBM Think, 9 de julio de 2025. Disponible en: https://www.ibm.com/mx-es/think/insights/ai-roi
[14] Thomson Reuters, "Future of Professionals 2026," Thomson Reuters, 22 de junio de 2026.
[15] Infobae (citando PwC Global CEO Survey y datos de MIT NANDA), "El 80% de las Empresas Perdió la Carrera de la IA y no se Enteró," Infobae, 20 de abril de 2026. Disponible en: https://www.infobae.com/tecno/2026/04/20/el-80-de-las-empresas-perdio-la-carrera-de-la-ia-y-no-se-entero/
[16] Banco de México, módulo especial de inteligencia artificial de la Encuesta Mensual de Actividad Empresarial Regional (EMAER), en el Reporte sobre las Economías Regionales, junio de 2026: 48.5% de uso actual y 64.8% de uso esperado en tres años en establecimientos de más de 100 trabajadores. Recuadro original: https://www.banxico.org.mx/publicaciones-y-prensa/reportes-sobre-las-economias-regionales/recuadros/%7BA51F5D48-C7C5-5E8A-1193-0E54C54068E0%7D.pdf. El cuestionario replica el de un panel internacional de ejecutivos donde 9 de cada 10 empresas no reportan impacto en empleo ni productividad a tres años: I. Yotzov, J. M. Barrero, N. Bloom et al., NBER Working Paper 34836, 2026, https://doi.org/10.3386/w34836.
Evidencia
- México ocupa el puesto 76 de 121 países en uso de Claude per cápita (0.63x). El índice no ajusta por ingreso; al ajustarlo, el PIB por persona en edad de trabajar explica 84.5% de su varianza y México queda en el lugar 109 de 120. Con un ingreso casi igual al de Argentina usa 0.63x contra 1.48x.Anthropic Economic Index y PIB 2024, análisis propio
- El INEGI publica que 2.1% de las 1,266,352 unidades que usaron herramientas digitales reporta sistemas de IA (26,093 unidades). Sobre el total de 5,451,113 unidades económicas son 0.5%, una re-base propia. Las encuestas de proveedores reportan 60% o más, pero no muestrean a las unidades sin internet.INEGI, Censos Económicos 2024 (año de referencia 2023)
- De 25 atributos organizacionales analizados, el rediseño de flujos de trabajo es el que más correlaciona con impacto en EBIT, y solo 21% de los adoptantes lo ha hecho.McKinsey, State of AI 2025 (1,993 organizaciones en 105 países)
- Cuatro estudios independientes, con metodologías y muestras distintas, llegan al mismo rango: entre 5% y 12% de las organizaciones captura valor financiero real de la IA.McKinsey, BCG, MIT NANDA y PwC
- En la ocupación mediana con algún uso de IA, esta se aplica a solo 21% de sus tareas, y la automatización de punta a punta es menos del 10% de las conversaciones cognitivas no rutinarias.Google AI & Economy ATLAS v1.0
- La correlación entre adopción de IA y productividad en la manufactura mexicana es observacional, no causal: es plausible que las empresas ya más productivas sean también las que adoptan más fácil.Centro México Digital sobre Censos Económicos 2024
- RETIRADA el 12-oct-2026. La correlación volumen-amplitud entre los 25 estados (r = 0.957) no distingue adopción de umbral de privacidad: un modelo donde ningún estado tiene más amplitud real que otro produce r = 0.961 (IC 95% 0.942 a 0.976).Simulación propia, scripts/tesis/nulo-amplitud.py
- "Homework" es el tema más frecuente en 99 de 121 países y a nivel global (6.41%). En América Latina, Perú, Colombia, Chile, Costa Rica y Argentina tienen más Homework que México y más uso. No es un dato sobre México.Anthropic Economic Index, análisis propio
- El módulo de IA de la EMAER de Banxico (junio de 2026) reporta 48.5% de uso en establecimientos de más de 100 trabajadores, y el censo refiere a 2023. La brecha entre censo y encuestas no es solo de definición: también es de población muestreada y de fecha.Banxico, citado vía prensa; original por verificar
- Todo el análisis de México mide un solo producto de un solo proveedor. Ni OpenAI ni Google publican desglose para México, así que la comparación entre proveedores es necesariamente asimétrica.
- El corte del dataset cubre solo dos meses (abril y mayo de 2026). No alcanza para afirmar una tendencia, y este documento se abstiene de proyectar una.
- El autor dirige una empresa cuyo modelo de negocio, una plataforma de operación con IA, se beneficia directamente de la conclusión de este documento. El conflicto de interés se declara en la Sección 1.2 y se retoma en Limitaciones.
- MIT NANDA, una de las cuatro fuentes que sostienen el rango de 5% a 12%, no está revisada por pares y tiene muestra pequeña. Se cita solo por consistencia con las otras tres, nunca de forma aislada.
Revisiones
- nace
- reestructurado a formato académico: Resultados y Discusión separados, preguntas de investigación explícitas (P1–P4) respondidas en Conclusiones, declaración de conflicto de interés, sección de Trabajo futuro. Se cuantifica la relación volumen-amplitud que antes solo se afirmaba a partir de la gráfica (r = 0.957, ρ = 0.944, n = 25). Tablas y categorías ocupacionales traducidas al español, con la equivalencia al original SOC en el Anexo A.
- corrección de cifras: la diferencia en mezcla de propósito entre estados líderes y rezagados es de 1.2 puntos porcentuales o menos (el uso escolar difiere 0.2), no "entre 1.0 y 1.2" ni "de 1 punto en las tres variables"; el resumen ejecutivo pasa de "13 veces" a 13.6, la cifra de la Tabla 8. Ningún resultado ni conclusión cambia.
- revisión escéptica externa y correcciones. (1) El 0.5% del INEGI era una re-base propia del 2.1% que el censo publica sobre las unidades con herramientas digitales; se corrige la atribución y la brecha deja de presentarse como solo de definición (también es de población muestreada y de fecha; se agrega el módulo EMAER de Banxico). (2) Se retira la respuesta a P3: un modelo nulo sin diferencias reales de amplitud produce r = 0.961 (IC 95% 0.942 a 0.976), así que r = 0.957 mide el umbral de privacidad y no adopción; salen r² y la amplitud como evidencia. (3) Homework deja de usarse como evidencia sobre México: es el tema número 1 en 99 de 121 países. (4) P2 se reargumenta con una regresión contra ingreso (R² = 0.845; México en el lugar 109 de 120) y se corrige la descripción del índice, que no ajusta por PIB. (5) Se retiran las referencias [13] y [14], blogs comerciales de implementadores de Odoo, y la afirmación de costo de ERP que sostenían. La tesis central sigue en pie con el capítulo estatal abierto. (5) La afirmación central se reformula en versión débil: la distinción entre herramienta y proceso importa, pero la versión fuerte («y no la disponibilidad de la tecnología») está contradicha por experimentos con ganancias sin rediseño. Se verifica la EMAER de Banxico en el original y se matiza el rango 5-12%.
Cómo citar
Mateo Ramírez Mora (2026). Herramienta vs. Proceso: Por qué la Adopción de IA en México No se Traduce en Resultados. Investigación 001, Nuvnext.Revisada 12 de octubre de 2026. https://doi.org/10.5281/zenodo.21765176